
- RapidOCR odczytuje napisy z ekranu dwa razy na sekundę, ale polskie ogonki czasem gubi.
- MediaPipe znajduje twarz, kierunek głowy i spojrzenia, a HSEmotion ocenia emocje.
- Wszystkie trzy działają na procesorze; na moich trzech rolkach zajmowały razem 18–22 s na minutę wideo.
Trzynasta część serii dotyczy trzech małych modeli, które w moim studiu rolek pracowały na procesorze, obok dużych modeli na karcie graficznej. RapidOCR czyta tekst z ekranu, MediaPipe śledzi twarz, kierunek głowy i spojrzenie, a HSEmotion ocenia emocje na twarzy. Żaden z nich nie robi wrażenia sam w sobie, ale razem mówią, co widz czyta i na kogo patrzy. Testuję je na trzech moich rolkach na Macu mini M6 z 32 GB.
Tekst na ekranie
Napisy w rolce robią dwie rzeczy: przyciągają uwagę w pierwszych sekundach i trzymają ją u osób, które oglądają bez dźwięku. Żeby to ocenić, studio musi wiedzieć, jaki tekst jest na ekranie, kiedy i gdzie. Robi to OCR, czyli odczytywanie tekstu z obrazu.
Używam RapidOCR. To projekt, który przenosi modele z PaddleOCR do formatu ONNX, dzięki czemu działają na zwykłym procesorze bez dużych dodatkowych bibliotek. Do znajdowania tekstu używam modeli PP-OCRv5 w lekkiej wersji mobile, a do odczytu liter modelu latin_PP-OCRv5_mobile_rec. Według dokumentacji obejmuje on też język polski. Wszystkie modele zajmują razem około 13 MB.
Ustawienia z projektu:
- OCR czyta dwie klatki na sekundę,
- całą klatkę zmniejszam do 1280 pikseli na dłuższym boku,
- odrzucam odczyty poniżej progu pewności 0,6,
- napisy dodane w montażu odróżniam od tekstu w tle po wysokości: element niższy niż 2,5% wysokości kadru to raczej napis na koszulce albo ekranie laptopa niż podpis rolki.
Każda ramka tekstu daje dane do cech rolki: czy jest tekst w pierwszych trzech sekundach, jak gęste są napisy i czy tekst nie wchodzi w miejsca zasłaniane przez Instagram.
Twarz, głowa i spojrzenie
MediaPipe Face Landmarker to model Google, który znajduje na twarzy 478 punktów twarzy, w tym po 5 na każdej tęczówce, co opisuje praca Google. Zwraca też macierz obrotu, czyli liczby opisujące, jak bardzo obrócona jest głowa.
Studio liczy z tych danych dwie rzeczy:
- ze środków tęczówek i obrotu głowy, czy patrzę w kamerę,
- z wielkości twarzy w kadrze, czy to zbliżenie, czy plan ogólny.
Osobny model, MediaPipe Hand Landmarker, znajduje 21 punktów na każdej dłoni. Studio liczy z nich, jak szybko środek dłoni przesuwa się w kadrze, co jest prostą miarą gestykulacji.
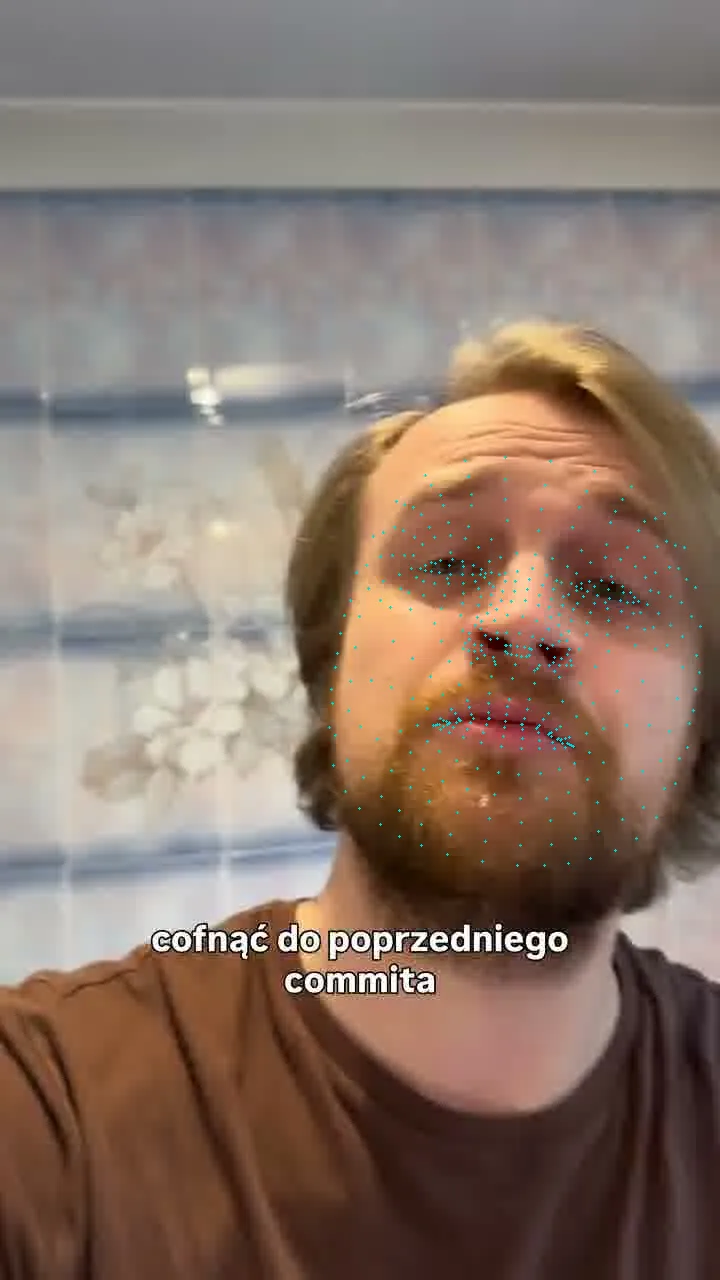
Jedna praktyczna uwaga z projektu: nowsza wersja biblioteki MediaPipe nie ma już starego sposobu uruchamiania o nazwie solutions. Przeszedłem więc na nowszy sposób, Tasks, z plikami modeli .task dołączonymi do repozytorium. Przy pionowych klatkach biblioteka ostrzega, że obraz nie jest kwadratowy, ale wykrywanie działa: w mojej rolce 47 s twarz była widoczna w 79% klatek.
Emocje
HSEmotion to zestaw lekkich sieci do rozpoznawania wyrazu twarzy. Według autorów uczono je między innymi na zbiorze AffectNet, czyli ponad milionie zdjęć twarzy opisanych ręcznie przez ludzi. Używam modelu enet_b0_8_best_afew, dostrojonego pod wideo (zbiór AFEW). Autor opisuje to podejście w pracy o rozpoznawaniu mimiki na urządzeniach mobilnych.
AffectNet ma własne warunki użycia, więc przed użyciem komercyjnym trzeba je sprawdzić. Ja używam emocji wyłącznie jako wewnętrznej miary w analizie własnych rolek. Korzystam z pakietu hsemotion-onnx na licencji Apache 2.0, z modelem, który rozpoznaje osiem rodzajów wyrazu twarzy. Wycinek twarzy z MediaPipe trafia do modelu kilka razy na sekundę, a wynikiem jest emocja z największym prawdopodobieństwem.
Do wyników tego modelu podchodzę ostrożnie. Rozpoznaje wygląd twarzy, a nie to, co człowiek czuje. Uśmiech przy mówieniu bywa odczytany jako radość niezależnie od treści.
Mój model przewidywania wyników nie korzysta więc z nazwy emocji, tylko z natężenia mimiki na początku rolki, czyli z tego, jak bardzo twarz odchodzi od neutralnej. Ta cecha była wśród ważniejszych dla polubień i komentarzy. Udział twarzy w całej rolce działał na minus dla zapisów i udostępnień, a na plus dla komentarzy. To nie znaczy, że należy chować twarz. Raczej to, że w rolkach, w których dużo mówię do kamery, liczy się też to, co poza moją twarzą dzieje się na ekranie.
| Co zwraca | Mediana na rolkę | Na minutę wideo | |
|---|---|---|---|
| RapidOCR PP-OCRv5 | tekst, pewność i ramka, 2× na sekundę | 36,6 s | 24,9 s |
| MediaPipe + HSEmotion | twarz, głowa, spojrzenie, dłonie, emocje | 12,8 s | 8,9 s |
Liczby ze studia są wyższe niż w moim pomiarze i nie ma w tym sprzeczności. W partii z 29 października było 47 rolek, a ich mediana długości wynosiła 90 s. OCR znajdował w medianie 9,5 fragmentu tekstu na klatkę, więcej niż w najgęstszej rolce testu (7,3). OCR płaci czasem za każdy fragment, więc minuta takiej rolki kosztuje więcej. Te same trzy rolki zajęły w studiu 4,5, 11,2 i 27,9 s OCR, czyli niewiele więcej niż w pomiarze, bo w partii obok OCR pracują też inne etapy analizy.
Z tych samych danych mój model wyciągnął jeszcze dwie rzeczy: duża twarz na początku rolki szła w parze z mniejszą liczbą udostępnień, a kontakt wzrokowy na początku rolki z większą liczbą obserwacji.
Na czym i jak mierzę
| Mac mini M6 (Mac18,5) | |
|---|---|
| Procesor | Apple M6, 12 rdzeni CPU: 2 Super, 4 Performance, 6 Efficiency |
| Grafika | 12 rdzeni GPU, Metal 4 |
| Pamięć | 32 GB pamięci wspólnej dla procesora i grafiki, przepustowość 170 GB/s |
| Dysk | SSD 512 GB (494 GB po sformatowaniu) |
| System | macOS 27.0.1 |
Biorę trzy moje rolki (26 s, 47 s i 90 s) i uruchamiam te same funkcje co w studiu. OCR mierzę trzy razy, a analizę twarzy z emocjami dwa razy. Zapisuję:
- czas pracy,
- liczbę odczytanych napisów,
- udział klatek z twarzą,
- udział klatek z kontaktem wzrokowym,
- pierwsze rozpoznane emocje.
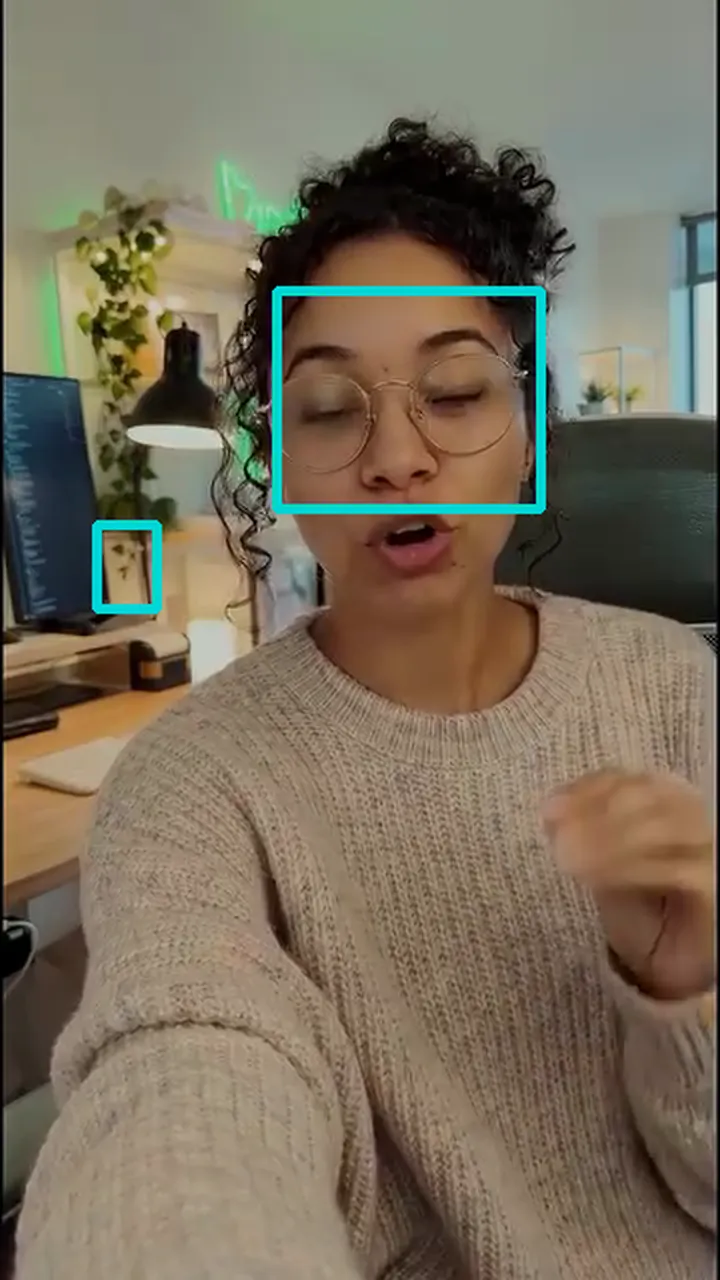
Do artykułu rysuję ramki tekstu na klatce z największą liczbą odczytów: w klipie z Veo i w mojej rolce 47 s z napisami. Pomiar robię na Macu, na którym nie działają inne ciężkie programy. Osobny, pojedynczy przebieg nagrałem w prawdziwym oknie Terminala.

Wyniki
Rolka 26 s (Veo 3.1) Rolka 47 s (telefon) Rolka 90 s (ekran) OCR: czas 3,4 s 8,3 s 25,1 s OCR: s na minutę wideo 7,8 s 10,6 s 16,7 s OCR: klatki / odczytane fragmenty tekstu 52 / 23 93 / 367 181 / 1316 Twarz i emocje: czas 4,6 s 6,1 s 7,7 s Twarz i emocje: s na minutę wideo 10,6 s 7,8 s 5,1 s Twarz w kadrze 100% 79% 31% Kontakt wzrokowy (gdy widać twarz) 50% 97% 98%
Czas OCR rośnie z ilością tekstu, a nie tylko z długością rolki. Rolka 90 s, w której przez większość czasu widać ekran komputera, dała 1316 fragmentów tekstu i kosztowała 16,7 s na minutę. Klip z Veo bez napisów kosztował tylko 7,8 s.
Analiza twarzy zachowuje się odwrotnie: w przeliczeniu na minutę jest najtańsza tam, gdzie twarzy jest mało. MediaPipe analizuje 10 klatek na sekundę w rozdzielczości 512 pikseli, a HSEmotion liczy emocje tylko na klatkach z twarzą. Każdy przebieg zaczyna się też od wczytania modeli, co w krótkiej rolce podnosi koszt na minutę. Cały test zajął najwyżej 1,1 GB pamięci, więc oba etapy spokojnie mieszczą się obok dużych modeli na karcie graficznej.
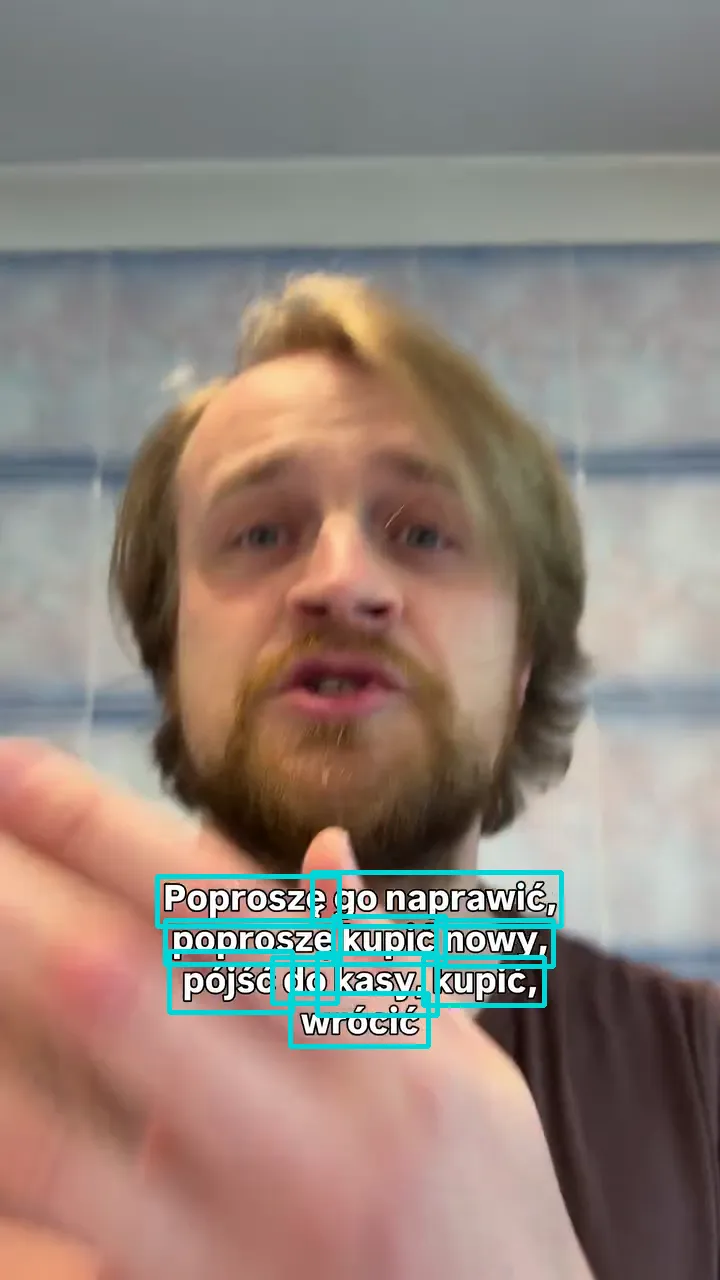
Na mojej rolce z napisami OCR znalazł i odczytał każde słowo, ale z polskimi znakami bywa różnie:
- w napisie „Poproszę go naprawić, poproszę kupić nowy, pójść do kasy, kupić, wrócić” słowo „Poproszę” w jednych klatkach wyszło poprawnie, a w sąsiednich jako „Poprosze”,
- „Pójść” zamieniło się w „pójé”, „pójśé” albo „pójsé” i tylko czasem wyszło poprawnie,
- w następnym napisie, „Nie, nie mogę wrócić do komita, nie mogę postawić worktree…”, OCR w każdej zapisanej klatce zapisał „mogę” jako „moge”, z pewnością 0,995–0,999.
To ważna lekcja: wysoka pewność nie oznacza poprawnych znaków diakrytycznych. Do wyszukiwania i liczenia słów warto więc porównywać tekst bez polskich znaków. Studio już to robi: przed porównaniem usuwa ogonki z każdego słowa.
Inaczej wygląda klip z Veo bez napisów (ramki wyżej). Tam OCR uznał za tekst oprawki okularów i obrazek na półce („29” i „6”). Przy rolkach bez napisów trzeba więc odrzucać pojedyncze, krótkie odczyty.
Analiza twarzy dała sensowne liczby. W moich nagraniach patrzę w kamerę przez 97–98% czasu, w którym widać twarz. W klipie z Veo tylko przez połowę, bo postacie rozmawiają ze sobą albo mają głowę obróconą o więcej niż 15°, a tyle studio uznaje za granicę kontaktu wzrokowego.
Emocje są mniej pewne:
- na początku rolki o drzwiach (47 s) model widział smutek z prawdopodobieństwem do 0,90, co pasuje do płaczliwej miny w pierwszych sekundach,
- w rolce o domenie (90 s), przy zwykłym mówieniu, podawał w pierwszych dwóch sekundach na zmianę „wstręt” i „zaskoczenie” z prawdopodobieństwem tylko 0,24–0,46, czego w tym nagraniu nie widzę.
Lokalnie czy przez API
Duże firmy chmurowe oferują odczyt tekstu i wykrywanie twarzy jako płatne usługi. Przy wideo szybko robi się z tego tysiące zapytań: dwie klatki na sekundę to 120 obrazów na każdą minutę rolki.
Można też wysłać klatki do modelu multimodalnego, na przykład Gemini. Według dokumentacji liczy on obraz do 384 pikseli jako 258 tokenów. Gemini umie zwrócić ramki obiektów (box_2d, w skali 0–1000), ale klatka 720 × 1280 to co najmniej dwa kafelki po 258 tokenów. Przy 120 klatkach na minutę każda rolka staje się serią płatnych zapytań.
OCR na własnym komputerze zwraca ramkę każdego fragmentu tekstu bez opłat, na procesorze. Nie zajmuje przy tym karty graficznej, która w tym czasie liczy inne modele.
Na co uważać
OCR myli się najczęściej na ozdobnych krojach pisma, na tekście na półprzezroczystym tle i na bardzo krótkich słowach. Pomaga próg pewności i odrzucanie elementów, w których nie ma liter ani cyfr.
Wykrywanie twarzy zawodzi, gdy twarz jest z profilu, w mocnym cieniu albo z zasłoniętymi ustami. Rozpoznawanie emocji zależy od kultury i sposobu mówienia.
Wszystkie trzy modele traktuję jako źródła danych do dalszej analizy, a nie gotowe odpowiedzi. O tym, jak budować takie oceny i sprawdzać je na własnych danych, piszę w artykule o własnych testach z Inspect i lm-eval.
Jak sprawdzić strefy interfejsu w swoich rolkach
To najbardziej praktyczne zastosowanie OCR na własnym komputerze, jakie znam. Aplikacje z krótkimi filmami zasłaniają część ekranu: na dole opis i przyciski, z boku ikony polubień i komentarzy, u góry nazwę konta. Strefy interfejsu to właśnie te miejsca. Tekstu, który tam trafi, widz po prostu nie przeczyta. W studiu sprawdzam to automatycznie dla każdej rolki.
Kontrola stref interfejsu z OCR
- 01Odczytaj ramki tekstuOCR dwa razy na sekundę, ramki zapisane względem rozmiaru całej klatki.
- 02Odrzuć tłoPomijam bardzo małe napisy, bo to raczej tekst w kadrze niż podpis rolki.
- 03Wyznacz strefyDolny pas na opis i przyciski, prawy pas na ikony, górny na nazwę konta.
- 04Policz kolizjeUdział klatek, w których ramka napisu wchodzi w strefę.
- 05Popraw szablonJeśli kolizji jest dużo, przesuwam napisy w szablonie, a nie w każdej rolce osobno.
W moim szablonie rolek karty z tekstem i dymki mają stałą szerokość i pozycję ustawioną tak, żeby omijały strefy interfejsu. Ten test pilnuje, żeby nowe rolki tego nie psuły.
Tak samo działa wykrywanie twarzy z MediaPipe: jeśli twarz jest za nisko, przykrywa ją opis, a jeśli za wysoko, nazwa konta. To proste zasady, ale bez automatycznej kontroli łatwo je przeoczyć.
Werdykt
Te trzy modele to niewidoczna, ale potrzebna część analizy wideo. Działają na procesorze, nie potrzebują dużo pamięci i dają dane, których duże modele językowe nie zwracają w użytecznej formie. RapidOCR i MediaPipe polecam bez zastrzeżeń. Rozpoznawanie emocji traktuję jako ciekawostkę i miarę natężenia mimiki, a nie jako ocenę uczuć.
W poprzednich częściach pisałem o modelach, które oglądają obraz i słuchają dźwięku. Kolejne części serii pojawiają się codziennie.