
- Na Macu mini M6 Whisper turbo na karcie graficznej zamienił 58 s nagrania na tekst w 1,5 s, około 14 razy szybciej niż large-v3 na procesorze (21,2 s).
- Bez słownika nazw obie wersje zapisały dobrze 5 z 11 nazw, a large-v3 ze słownikiem w hotwords wszystkie 10 wypowiedzianych.
- Obie zajmują 2,3–3,7 GB pamięci.
Zamiana mowy na tekst to pierwszy etap prawie każdego zestawu narzędzi do wideo: bez tekstu nie ma napisów, cięć w odpowiednim słowie ani oceny pierwszego zdania rolki. W trzeciej części serii sprawdzam dwie wersje Whispera, które mam na Macu mini M6 z 32 GB. Pierwsza to faster-whisper large-v3, która liczy na procesorze. Druga to whisper-large-v3-turbo, która liczy na karcie graficznej. Testuję je na polskim nagraniu pełnym nazw modeli AI, bo właśnie w takich nazwach transkrypcja na własnym komputerze myli się najczęściej.
Jak Whisper pracował w moim studiu rolek
W studiu rolek Whisper zamienia dźwięk na słowa, a do każdego słowa dodaje znaczniki czasu. Na ich podstawie studio liczy:
- zdania i ich granice,
- tempo mówienia w słowach na minutę,
- pauzę po pierwszym zdaniu,
- położenie napisów w montażu.
Ustawienia dobrałem pod szybkość i stabilność. Model large-v3 w wersji faster-whisper liczy na procesorze w formacie int8. Wyszukiwanie wiązką ma szerokość 1, czyli model zawsze bierze najbardziej prawdopodobne następne słowo. Filtr VAD pomija fragmenty bez mowy. Wyłączyłem też opcję, która dopisuje poprzedni tekst do kontekstu kolejnego fragmentu, bo przy rolkach z muzyką powodowała powtarzanie tych samych zdań.
Z tymi ustawieniami etap przeszedł przez wszystkie przebiegi analizy. Najdokładniej zmierzyłem przebieg na 47 moich rolkach z kanału: razem 79,2 minuty nagrań. Transkrypcja zajęła tam 42,5 minuty, czyli w medianie 31,8 s na każdą minutę wideo. To mniej więcej dwa razy szybciej, niż trwa nagranie, i to na samym procesorze. W całej analizie rolek (3,52 h na 47 rolek) transkrypcja była drugim najdłuższym etapem, po modelu ruchu.
| Łącznie | Mediana na rolkę | Na minutę wideo | |
|---|---|---|---|
| Ruch (V-JEPA 2) | 71,2 min | 87,0 s | 52,5 s |
| Transkrypcja (Whisper) | 42,5 min | 44,1 s | 31,8 s |
| Napisy na ekranie (OCR) | 37,2 min | 36,6 s | 24,9 s |
| Kadry (DINOv2, estetyka) | 15,1 min | 18,0 s | 12,1 s |
| Dźwięk (AST, CLAP) | 14,9 min | 16,1 s | 10,5 s |
| Twarz (MediaPipe) | 13,4 min | 12,8 s | 8,9 s |
Whisper po polsku ma jedną słabość, którą znam z praktyki: nazwy własne. „DINOv2”, „V-JEPA2”, „Qwen” czy „CatBoost” wypowiedziane w polskim zdaniu zamieniają się w podobnie brzmiące słowa. Dlatego przy transkrypcji moich nagrań do montażu studio podaje listę nazw w ustawieniu initial_prompt. Ten test sprawdza, ile taka lista naprawdę daje.
Dwie wersje: large-v3 i turbo
Według karty modelu large-v3-turbo to zmniejszony large-v3. Ma 4 warstwy dekodera zamiast 32 i 809 mln parametrów zamiast 1,55 mld. Dekoder pisze tekst token po tokenie, więc to on najbardziej wpływa na czas pracy. Autorzy piszą, że turbo traci przez to niewiele jakości.
Obie wersje uruchamiam inaczej. Turbo działa przez MLX na karcie graficznej Maca. Large-v3 działa przez faster-whisper, czyli wersję Whispera zbudowaną na silniku CTranslate2. Ten silnik liczy na Macu tylko na procesorze: według dokumentacji CTranslate2 z kart graficznych obsługuje tylko NVIDIA i AMD.
Obie wersje opierają się na budowie opisanej w pracy OpenAI o Whisperze. Pierwszą wersję uczono na 680 tysiącach godzin nagrań z internetu. Large-v3 według karty modelu uczono na milionie godzin nagrań z przybliżonymi napisami i 4 milionach godzin nagrań, do których napisy przygotował wcześniejszy model.
| faster-whisper large-v3 | whisper-large-v3-turbo | |
|---|---|---|
| Parametry | 1,55 mld | 809 mln |
| Warstwy dekodera | 32 | 4 |
| Gdzie liczy na Macu | procesor, int8 | karta graficzna, MLX |
| Biblioteka | faster-whisper (CTranslate2) | mlx-audio |
| Licencja | MIT (konwersja), Apache 2.0 (oryginał) | MIT (model OpenAI) |
Na czym i jak mierzę
| Mac mini M6 (Mac18,5) | |
|---|---|
| Procesor | Apple M6, 12 rdzeni CPU: 2 Super, 4 Performance, 6 Efficiency |
| Grafika | 12 rdzeni GPU, Metal 4 |
| Pamięć | 32 GB pamięci wspólnej dla procesora i grafiki, przepustowość 170 GB/s |
| Dysk | SSD 512 GB (494 GB po sformatowaniu) |
| System | macOS 27.0.1 |
Tekstem wzorcowym jest surowe nagranie do jednej z moich rolek (w projekcie nazywa się v13): 58 sekund, w których czytam przygotowany scenariusz słowo w słowo. Scenariusz ma 124 słowa i dużo nazw: DINOv2, Whisper, AST, V-JEPA2, Claude, GPT, CatBoost, Qwen. Dzięki temu mogę policzyć WER, czyli jaki odsetek słów model zapisał źle. Osobno liczę, ile z jedenastu nazw własnych model zapisał poprawnie.
Każdą wersję uruchamiam w kilku wariantach, zawsze z językiem ustawionym na polski:
- bez listy nazw,
- z listą nazw w parametrze
initial_prompt, - large-v3 dodatkowo z listą nazw w parametrze hotwords.
Pomiar czasu powtarzam trzy razy. Do testu szybkości dokładam dłuższą rolkę (3:51, czyli 231,5 s). Dla każdego wariantu zapisuję czas, RTF, WER i liczbę poprawnych nazw. Pomiar robię na Macu, na którym nie działają inne ciężkie programy. Osobny, pojedynczy przebieg nagrałem w prawdziwym oknie Terminala.

Wyniki: szybkość
| large-v3, procesor (int8) | turbo, karta graficzna (MLX) | |
|---|---|---|
| Wczytanie modelu | 1,3 s | 0,3 s |
| Rolka 58 s, bez listy nazw | 21,2 s (RTF 0,37) | 1,5 s (RTF 0,026) |
| Rolka 58 s, z listą nazw | 22,0 s (RTF 0,38) | 1,5 s (RTF 0,026) |
| Rolka 3:51 (231,5 s) | 75,4 s (RTF 0,33) | 6,5 s (RTF 0,028) |
| Największe zużycie pamięci | 3,7 GB (cały proces) | 2,3 GB (MLX) |
RTF poniżej 1 oznacza, że model liczy szybciej, niż trwa nagranie. Przy RTF 0,33 minuta mowy to około 20 sekund pracy procesora, a przy 0,026 to półtorej sekundy pracy karty graficznej. Trzy przebiegi różniły się najwyżej o 0,42 s na procesorze i o 0,09 s na karcie graficznej, więc mediana dobrze opisuje typowy czas.

Turbo na karcie graficznej był około 14 razy szybszy na krótkiej rolce i 12 razy szybszy na długiej. Minuta mowy to dla niego około 1,6 s, a dla large-v3 na procesorze około 20 s.
Żadna wersja nie potrzebuje dużo pamięci: large-v3 w int8 zajął 3,7 GB, a turbo 2,3 GB. To jednak dwie różne miary. Dla procesora podaję pamięć całego procesu, a dla MLX tylko pamięć danych modelu, więc nie porównuj ich bardzo dokładnie. Na Macu z 32 GB obie wersje zmieszczą się obok dużego modelu językowego. Na dysku też zajmują mało: 3,1 GB large-v3 i 1,6 GB turbo.
To nie jest czyste porównanie procesora z kartą graficzną, bo różni się kilka rzeczy naraz:
- model: large-v3 jest większy niż turbo,
- sprzęt: procesor albo karta graficzna,
- ustawienia: na procesorze liczę dodatkowo znaczniki czasu słów i filtr VAD, a w mlx-audio nie.
Część przewagi turbo wynika więc z mniejszego dekodera, a część z tego, że nie wykonuje tej dodatkowej pracy. Kto chce porównać same układy, może uruchomić turbo także w faster-whisper na procesorze.
Ciekawe jest porównanie z projektem. Tam etap transkrypcji trwał 31,8 s na minutę wideo, a w teście large-v3 potrzebował około 20 s. W projekcie mierzyłem cały etap razem z przygotowaniem pliku, a w teście tylko samą transkrypcję gotowego pliku 16 kHz. Różnica to czas wszystkiego, co dzieje się wokół modelu. Lista nazw w initial_prompt wydłuża pracę na procesorze o niecałą sekundę, a na karcie graficznej praktycznie nic nie kosztuje.
Wyniki: jakość i nazwy własne
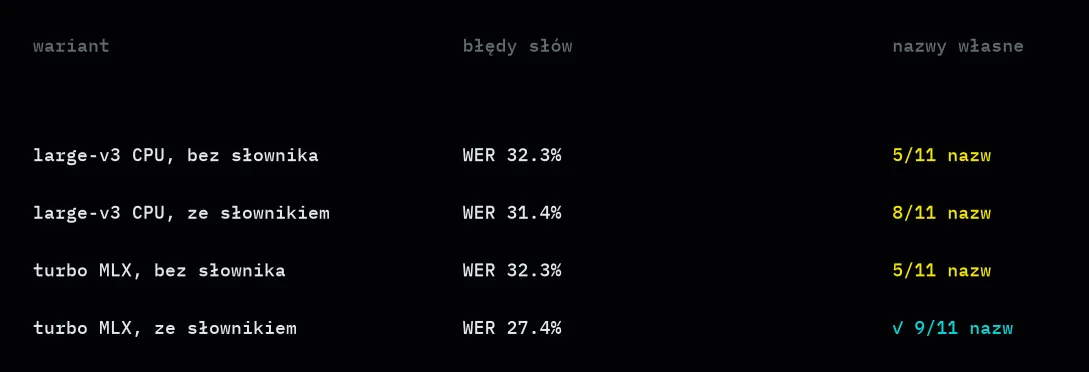
| WER wobec scenariusza | WER wobec tego, co powiedziałem | Nazwy poprawnie (z 11) | |
|---|---|---|---|
| large-v3, procesor, bez listy nazw | 0,323 | 0,057 | 5 |
| large-v3, procesor, lista w initial_prompt | 0,315 | 0,057 | 8 |
| large-v3, procesor, lista w hotwords | 0,290 | 0,036 | 10 |
| turbo, karta graficzna, bez listy nazw | 0,323 | 0,064 | 5 |
| turbo, karta graficzna, lista w initial_prompt | 0,274 | 0,021 | 9 |
Trzy przebiegi każdego wariantu dały identyczny tekst i identyczny WER. Na procesorze używam wiązki o szerokości 1, więc wynik jest za każdym razem taki sam.
Jedenaście nazw to: DINOv2, Whisper, AST, V-JEPA2, Claude, GPT, CatBoost, Qwen, RAM-u, API i viral. Lista nazw zawierała większość z nich, więc wynik z listą to najlepszy możliwy przypadek: znam nazwy z góry. W prawdziwym montażu tak właśnie jest, bo wiem, o czym mówię w nagraniu.
Bez listy nazw obie wersje pomyliły się prawie w tych samych miejscach:
- „CatBoost” zmienił się w „cut boost”,
- „Qwen” zmienił się w „Kłęt” (large-v3) albo „Kłę” (turbo),
- „V-JEPA2” zmienił się w „VJEPA2” albo „VJEPA 2”,
- turbo zapisał „Claude” jako „CLOD”, a large-v3 skleił „AST527”.
Lista nazw w initial_prompt poprawiła w large-v3 trzy nazwy: AST, V-JEPA2 i RAM-u. Tej ostatniej nie było na liście, więc to efekt uboczny podpowiedzi. Turbo z listą zapisał dobrze dodatkowo CatBoost i Qwen, więc na tym nagraniu poradził sobie lepiej niż większy model.
Large-v3 z listą dopisał za to na końcu zdanie „Dziękuje za uwagę.”, którego w nagraniu nie ma. To znana halucynacja Whispera: badanie „Careless Whisper” łączy takie dopiski z dłuższymi fragmentami bez mowy. Filtr ciszy (Silero VAD) był włączony, a dopisek i tak się pojawił. Dlatego w faster-whisper warto ustawić też parametr hallucination_silence_threshold, który działa razem ze znacznikami czasu słów.
Jedenastej nazwy, „API”, nie zapisał dobrze żaden wariant z prostego powodu: przy nagraniu zmieniłem zakończenie scenariusza i tego słowa w ogóle nie powiedziałem. Prawdziwy wynik z listą w initial_prompt to więc 8 i 9 z 10 wypowiedzianych nazw.
Przy sprawdzaniu tekstu znalazłem szczegół, który zmienia wnioski. W faster-whisper, gdy poprzedni tekst nie jest dopisywany do kontekstu, lista z initial_prompt działa tylko w pierwszym 30-sekundowym fragmencie nagrania. Po każdym fragmencie kontekst jest czyszczony, co widać w kodzie biblioteki. CatBoost i Qwen padają w moim nagraniu w 29. i 38. sekundzie, więc large-v3 nie miał szans ich zapisać dobrze. mlx-audio domyślnie przenosi podpowiedź do kolejnych fragmentów, dlatego turbo wypadł lepiej.
Powtórzyłem więc pomiar large-v3 z parametrem hotwords, który faster-whisper dokłada do każdego fragmentu. Wynik: wszystkie 10 wypowiedzianych nazw zapisanych poprawnie, w czasie 22,3 s, prawie takim samym jak z initial_prompt (22,0 s). To najważniejsza praktyczna wskazówka z tej części: w faster-whisper listę nazw podawaj w hotwords.
Dlaczego w tabeli są dwie wartości WER? Tekstem wzorcowym jest scenariusz, ale w nagraniu odszedłem od niego w kilkunastu miejscach. Dodałem słowa „AI”, „jedną”, „dajemy”, „troszkę”, „Oczywiście” i zmieniłem zakończenie. Obie wersje zgodnie zapisują te dodatki, więc WER około 0,3 wobec scenariusza mierzy głównie moje odstępstwa i to, że modele zapisują liczby cyframi, a nie słowami.
Przygotowałem więc drugi tekst wzorcowy: to, co naprawdę powiedziałem. Odtworzyłem go ze scenariusza i z miejsc, w których obie wersje zapisały to samo, a liczby w transkrypcjach zamieniłem na słowa. W porównaniu z tym tekstem Whisper robi od 2 do 6 błędów na 100 słów, czyli jest naprawdę dokładny. Skrypt z tym tekstem jest w repozytorium testów. W dwóch miejscach, w których wersje zapisały co innego, zostawiłem słowa ze scenariusza.
Jak uruchomić to u siebie
Obie wersje da się uruchomić w kilka minut. Na Macu z procesorem M wystarczy Python i jedna biblioteka na wersję. Poniżej najprostszy przykład, od którego zaczynam. Pierwsze uruchomienie pobierze model (około 3,1 GB dla large-v3), a kolejne działają już bez internetu.
pip install faster-whisper
python -c "from faster_whisper import WhisperModel; m = WhisperModel('large-v3', device='cpu', compute_type='int8'); seg, info = m.transcribe('rolka.wav', language='pl', vad_filter=True, word_timestamps=True, beam_size=1, condition_on_previous_text=False, hotwords='DINOv2, Qwen, CatBoost'); print(' '.join(s.text for s in seg))"
Wersję turbo na karcie graficznej uruchamiam przez bibliotekę mlx-audio i model ze zbioru społeczności MLX: generate_transcription(model="mlx-community/whisper-large-v3-turbo", audio="rolka.wav", language="pl") z modułu mlx_audio.stt.generate.
Jest tu jedna pułapka. Paczka MLX zawiera tylko model i konfigurację, bez tokenizera, czyli narzędzia, które dzieli tekst na tokeny. Dołożyłem go z oficjalnego repozytorium OpenAI (WhisperProcessor.from_pretrained("openai/whisper-large-v3-turbo")). Nowsza paczka whisper-large-v3-turbo-asr-fp16 ma tokenizer w środku, więc z nią tej pułapki nie ma.
Według ogłoszenia OpenAI turbo douczono tylko na danych do transkrypcji, bez tłumaczenia. Dlatego nie nadaje się do tłumaczenia mowy na angielski.
Plik dźwiękowy najlepiej przygotować wcześniej: jeden kanał (mono), częstotliwość próbkowania 16 kHz. Studio robi to jednym poleceniem ffmpeg przed transkrypcją, bo wtedy wszystkie modele dźwiękowe w studiu dostają ten sam plik.
Problemy, które spotkałem w projekcie
Kilka rzeczy wyszło dopiero na setkach prawdziwych rolek, a nie na jednym nagraniu testowym:
- Rolki z piosenką w tle: Whisper zapisuje tekst piosenki tak samo jak mowę. Przy ocenie pierwszego zdania studio musiało więc sprawdzać, czy słowa w ogóle mówi osoba przed kamerą.
- Język: przy rolce bez mowy rozpoznawanie języka daje przypadkowy wynik. Dlatego gdy w rolce nie ma słów, zapisuję język jako nieznany i nie ufam temu rozpoznaniu.
- Powtórzenia: gdy poprzedni tekst był dopisywany do kontekstu, model potrafił powtarzać to samo zdanie przez kilkanaście sekund muzyki. Wyłączenie tej opcji usunęło problem.
- Wczytywanie pliku: z moim zestawem bibliotek faster-whisper zgłaszał błędy, gdy podawałem mu ścieżkę do pliku. Pomogło wczytanie dźwięku do pamięci i podanie modelowi gotowych danych.
Żaden z tych problemów nie zależy od tego, czy liczysz na własnym komputerze, czy przez API. Na własnym komputerze łatwiej jednak znaleźć ich przyczynę, bo widzisz każdy krok.
Lokalnie czy przez API
Transkrypcja przez API, czyli płatną usługę w chmurze, jest tania. W cenniku ElevenLabs model Scribe v2 kosztuje 0,22 USD za godzinę nagrania.
Gemini liczy dźwięk w tokenach. Według dokumentacji Google to 32 tokeny na sekundę, czyli 1920 tokenów na minutę. 79,2 minuty moich rolek to około 152 000 tokenów. Przy cenie 0,50 USD za milion tokenów dźwięku w Gemini 3.1 Flash-Lite daje to kilka centów, plus koszt tekstu, który model zwraca. Gemini 3.5 Flash-Lite, którego używam w innych częściach, liczy dźwięk po 0,30 USD, ale tekst odpowiedzi po 2,50 USD, więc wynik jest podobny: około 0,11 USD.
| Czas | Koszt | |
|---|---|---|
| large-v3 na procesorze (RTF 0,33–0,38) | ok. 26–30 min | 0 USD za wywołania |
| turbo na karcie graficznej (RTF 0,026–0,028) | ok. 2 min | 0 USD za wywołania |
| ElevenLabs Scribe v2 (0,22 USD/h; lista nazw jako keyterm prompting +0,05 USD/h) | zależy od sieci | ok. 0,29 USD (z listą nazw ok. 0,36 USD) |
| Gemini 3.1 Flash-Lite (dźwięk 0,50 USD za milion tokenów, ok. 152 tys. tokenów; tekst odpowiedzi 1,50 USD za milion) | zależy od sieci | ok. 0,08 USD + ok. 0,04 USD za tekst (szacunek: ok. 12 tys. słów, ok. 2 tokeny na polskie słowo, minimalny poziom myślenia) |
Czasy na Macu to RTF z mojego testu przeliczony na całe 79,2 minuty. Ceny API pochodzą z oficjalnych cenników z listopada 2026, a płatnych wywołań nie wykonywałem.
Cena nie jest więc powodem, żeby używać Whispera na własnym komputerze. Powody są trzy inne:
- znaczniki czasu słów: faster-whisper daje je od razu, a studio buduje z nich cięcia i napisy,
- prywatność: surowe nagrania z kamery nie wychodzą z mojego dysku,
- kontrola: wersja modelu, lista nazw i ustawienia nie zmienią się w połowie projektu.
Jeśli tworzysz treści z AI, szerzej opisuję te wybory w przewodniku o obrazie, wideo i głosie z AI.
Werdykt
Lista nazw zmienia wynik bardziej niż wybór wersji, pod warunkiem że podasz ją we właściwym parametrze. Bez niej obie wersje zapisują dobrze 5 z 11 nazw. Z initial_prompt large-v3 zapisuje dobrze 8 nazw, a turbo 9. Large-v3 z listą w hotwords zapisuje dobrze wszystkie 10 wypowiedzianych.
W porównaniu z tym, co naprawdę powiedziałem, najdokładniejszy był turbo z podpowiedzią (WER 0,021), a tuż za nim large-v3 z hotwords (0,036). Turbo przez MLX wygrywa szybkością (14 razy), a large-v3 z hotwords poprawnością nazw. Large-v3 na procesorze wybieram wtedy, gdy karta graficzna jest zajęta innym modelem. Na Macu z 32 GB, na którym pracuje kilka modeli po kolei, to częsta sytuacja.
Model działa w całości na komputerze, więc pasuje do zestawów narzędzi, w których nagrania są prywatne. Takie zestawy buduję razem z klientami w ramach automatyzacji i agentów AI. W pierwszej części serii mierzyłem model językowy Qwen3.6 na Macu mini, a w następnej zajmę się mówiącym awatarem.