
- FLUX.1 Kontext dev zmienia zdjęcie według polecenia tekstowego i zostawia resztę kadru bez zmian.
- Na Macu mini z 32 GB działa w ComfyUI w wersji Q8, jeśli enkoder tekstu i model pracują po kolei, a nie naraz.
- Wyniki wolno używać komercyjnie, ale sam model ma licencję niekomercyjną: wyjaśniam, co z tego wynika.
W drugiej części serii sprawdzam model, który nie tworzy obrazów od zera, tylko poprawia istniejące zdjęcia. FLUX.1 Kontext dev dostaje zdjęcie i polecenie, na przykład „usuń dłoń z mikrofonem, zamień lampę na turkusowy trójkąt”, i zmienia tylko to, o co prosisz. W moim studiu rolek przygotował klatkę startową dla mówiącego awatara. Sprawdzam, ile to trwa na Macu mini M6 z 32 GB, ile zajmuje pamięci i jak wygląda efekt przed i po.
Do czego potrzebuję edycji klatki w studiu rolek
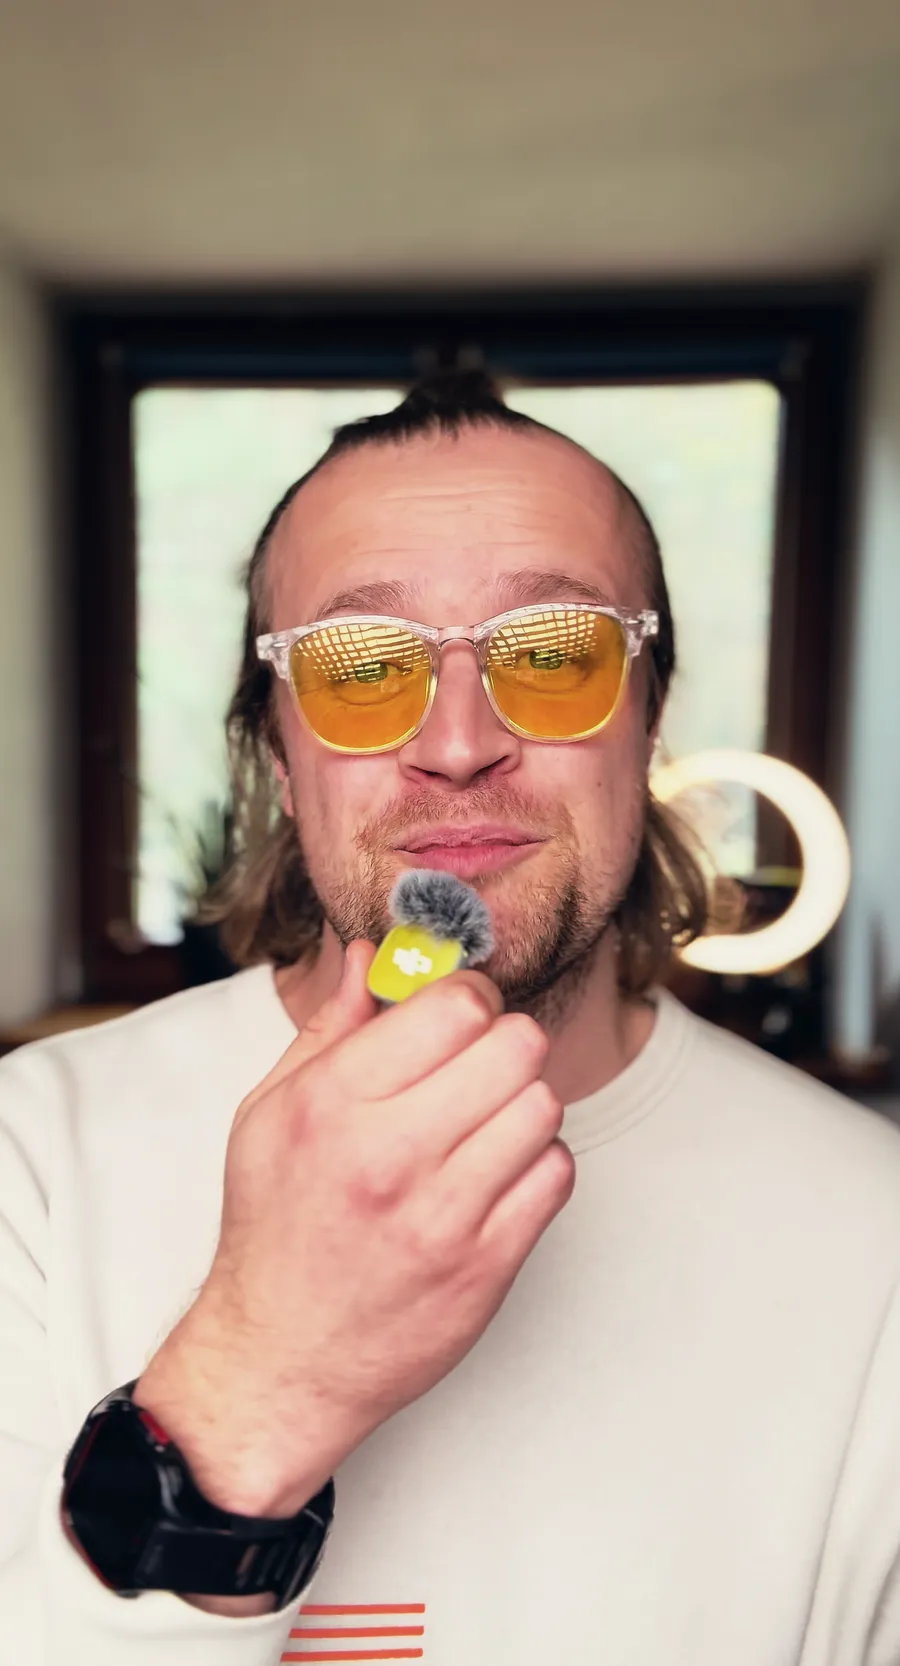
Awatar AI w mojej rolce powstaje z jednej klatki startowej i nagrania głosu. Model wideo animuje tę klatkę: porusza ustami, głową i mimiką. Wszystko, co jest na klatce startowej, zostaje w całym filmie. Na moim nagraniu trzymałem w dłoni puchaty mikrofon, a po prawej stronie świecił okrągły ring light, czyli lampa w kształcie pierścienia. Mikrofon zasłaniał podbródek tuż pod ustami, czyli dokładnie to miejsce, które awatar ma animować. Ring light nie pasował do mojej marki.
Zamiast nagrywać wszystko od nowa, poprawiam jedną klatkę. Polecenie z projektu jest po angielsku i mówi modelowi trzy rzeczy:
- usuń dłoń z mikrofonem, a ręce mają być luźno opuszczone poza kadr,
- zamień ring light na świecącą turkusową lampę w kształcie trójkąta, w tym samym miejscu i tej samej wielkości,
- twarz, pomarańczowe okulary, włosy, brodę, bluzę, okno, pokój i światło zostaw dokładnie takie same.
To dobry test, bo łączy usunięcie przedmiotu, dodanie nowego i zachowanie twarzy, na którą widzowie patrzą najuważniej.
Model i jak działa na Macu
FLUX.1 Kontext dev to model firmy Black Forest Labs do edycji obrazu poleceniem tekstowym. To model dyfuzyjny z 12 mld parametrów: zaczyna od szumu i w kolejnych krokach dochodzi do obrazu zgodnego z poleceniem i ze zdjęciem wejściowym.
Pełna wersja modelu jest za duża, żeby wygodnie pracować z nią na 32 GB pamięci. Dlatego używam wersji po kwantyzacji Q8, zapisanej w formacie GGUF. Uruchamiam ją w ComfyUI z dodatkiem ComfyUI-GGUF, który umie wczytywać takie pliki.
Polecenie tekstowe zamieniają na liczby dwa enkodery tekstu: T5 (też w wersji Q8) i CLIP-L. ComfyUI działa bez okna, jako serwer, i liczy na karcie graficznej Maca przez PyTorch MPS.
| Plik | Rozmiar | |
|---|---|---|
| Model obrazu | flux1-kontext-dev-Q8_0.gguf | 12,7 GB |
| Enkoder tekstu | t5-v1_1-xxl-encoder-Q8_0.gguf | 5,06 GB |
| Drugi enkoder | clip_l.safetensors | 246 MB |
| Dekoder obrazu (VAE) | ae.safetensors | 335 MB |
Najważniejsza lekcja z projektu dotyczy pamięci: enkoder tekstu i model obrazu nie powinny być w pamięci jednocześnie. Dlatego studio koduje polecenie raz, zapisuje wynik na dysk i uruchamia serwer ComfyUI od nowa przed właściwą edycją. Serwer startuje z opcją --cache-none, czyli nie trzyma modeli w pamięci między zadaniami, więc każde zadanie zaczyna z pustą pamięcią. Modele trzeba przez to wczytywać za każdym razem od nowa, ale system nie musi używać pliku wymiany na dysku.
Na czym i jak mierzę
| Mac mini M6 (Mac18,5) | |
|---|---|
| Procesor | Apple M6, 12 rdzeni CPU: 2 Super, 4 Performance, 6 Efficiency |
| Grafika | 12 rdzeni GPU, Metal 4 |
| Pamięć | 32 GB pamięci wspólnej dla procesora i grafiki, przepustowość 170 GB/s |
| Dysk | SSD 512 GB (494 GB po sformatowaniu) |
| System | macOS 27.0.1 |
Na wejściu jest klatka z jednego z moich nagrań (w projekcie nazywa się v11). Skrypt wybrał ją automatycznie: jest ostra, usta są zamknięte, a twarz patrzy prosto w kamerę. Pliki modeli leżą na zewnętrznym dysku SSD podłączonym przez USB.
Edycję uruchamiam z tymi samymi ustawieniami co w projekcie: 24 kroki, guidance 2,5, metoda próbkowania euler i trzy różne wartości ziarna losowości (1, 2 i 3). Mierzę:
- czas każdej edycji (pierwsza obejmuje też zakodowanie polecenia i ponowne uruchomienie serwera),
- najmniejszą ilość wolnej pamięci w czasie pracy,
- największy rozmiar pliku wymiany.
Pomiar robię na Macu, na którym nie działają inne ciężkie programy. Osobny, pojedynczy przebieg nagrałem w prawdziwym oknie Terminala.

Wyniki: przed i po
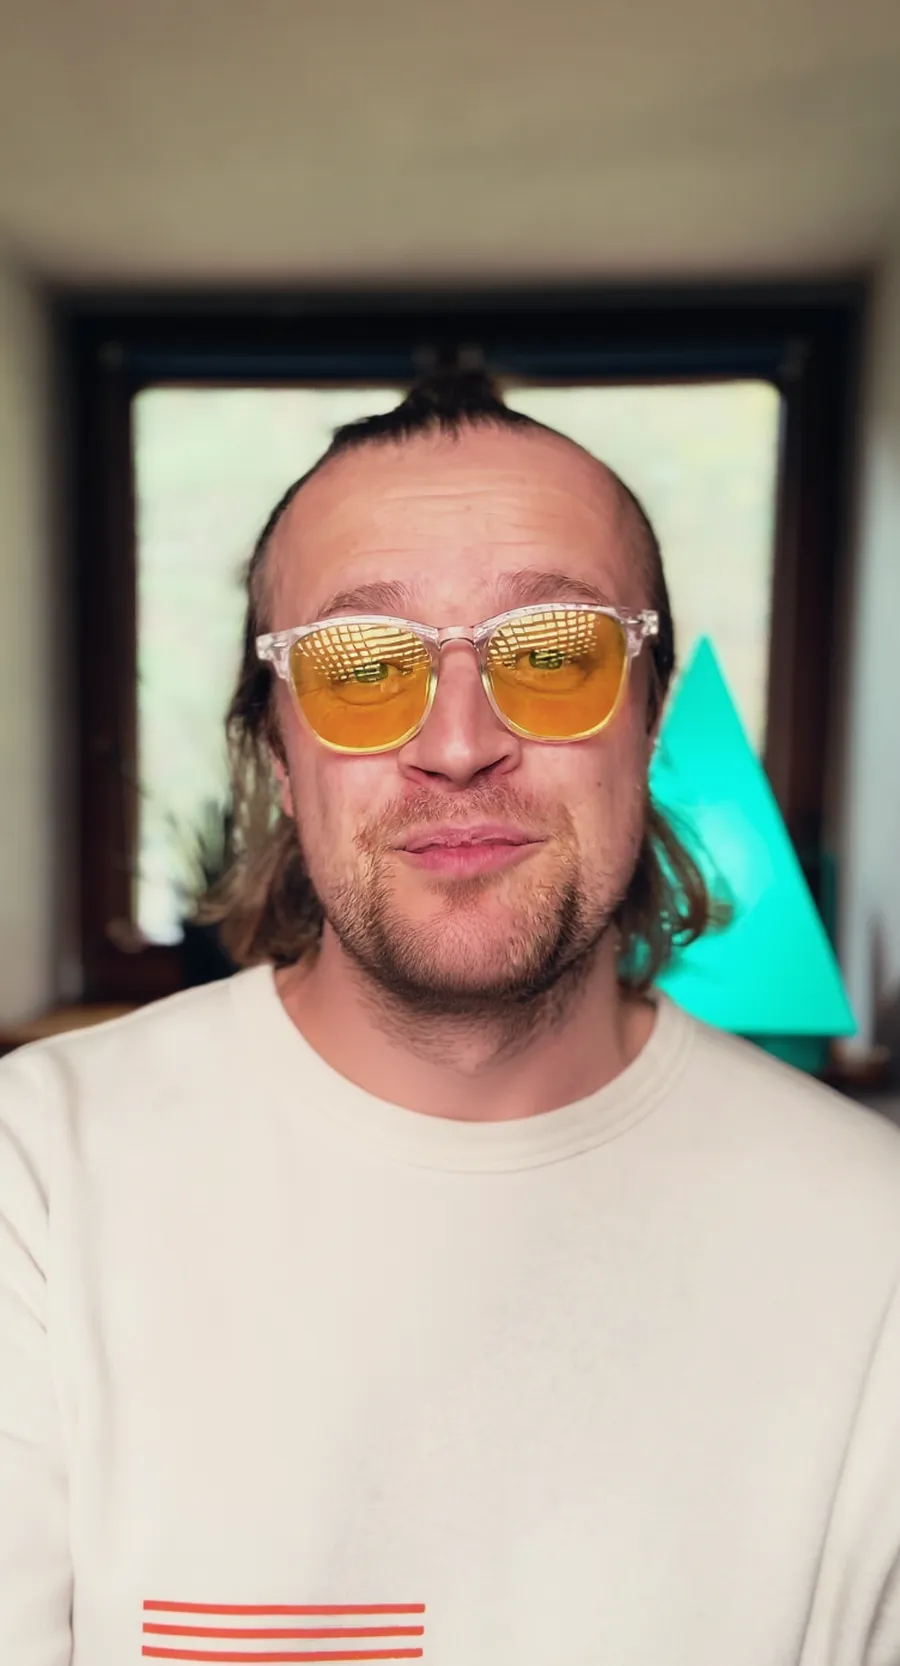
Najważniejsze części polecenia zadziałały we wszystkich trzech wariantach:
- dłoń z mikrofonem zniknęła, a w jej miejscu model dorysował gładki przód bluzy z okrągłym ściągaczem, bez śladów po palcach,
- okrągły ring light zmienił się w turkusową lampę w kształcie trójkąta,
- twarz, pomarańczowe okulary z odbiciem okna, kształt fryzury, broda i okno zostały bez widocznych zmian, a światło w pokoju pada z tej samej strony.
Model zrobił też dwie rzeczy, o które go nie prosiłem. Dorysował fragment pasów na bluzie, który wcześniej zasłaniało przedramię (w każdym wariancie inną długość). Dodał też turkusowy odblask nowej lampy na włosach, choć polecenie prosiło o niezmienione światło.
Wynik ma 752 piksele szerokości, więc na suwaku jest mniej ostry niż oryginał w 4K. To skutek mniejszej rozdzielczości, a nie zmiana twarzy.
Najwięcej swobody model wziął sobie przy lampie. W wariancie 2, który wybrałem do suwaka, lampa stoi za moim ramieniem i częściowo chowa się za włosami. W wariancie 1 świeci jaśniej i ma jasny punkt w środku. W wariancie 3 stoi na cienkiej nóżce i cała mieści się w kadrze. Żaden wariant nie stoi dokładnie w tym samym miejscu i nie ma tej samej wielkości co ring light, choć polecenie o to prosiło. Model zrozumiał, o jaką zmianę chodzi, ale nie odwzorował położenia i rozmiaru. Wszystkie trójkąty są wyraźnie większe od ring lighta (1,3–1,8 raza wyższe) i wszystkie sięgają do wysokości okularów, w wariancie 1 nawet wyżej, a ring light zaczynał się na wysokości nosa.
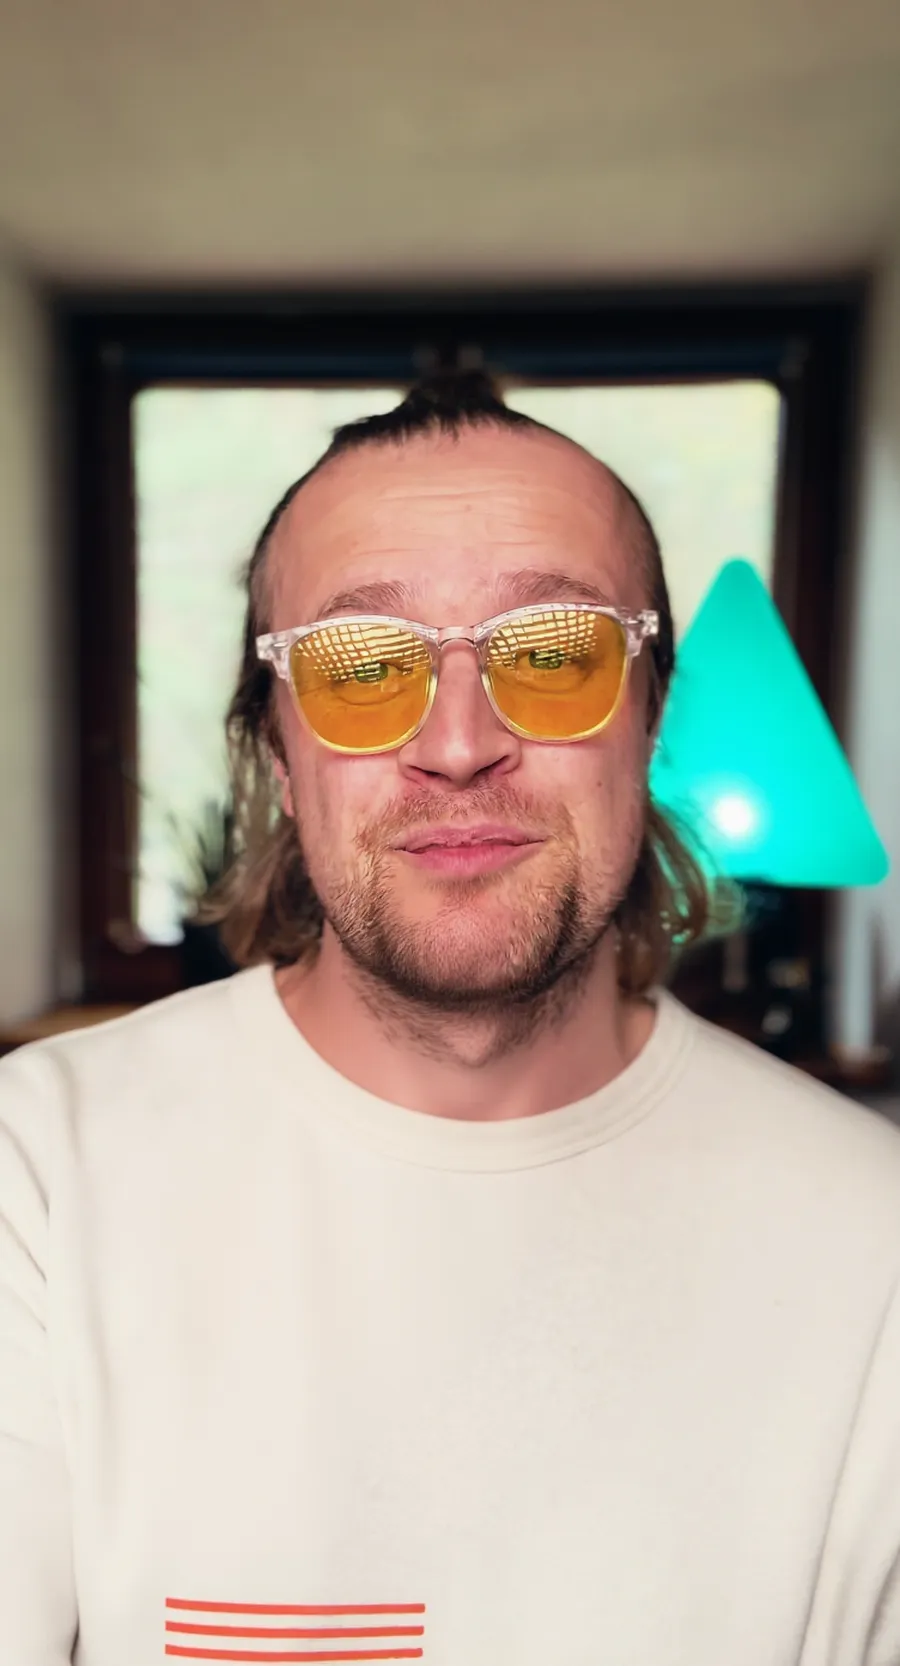 seed 1
- seed 2
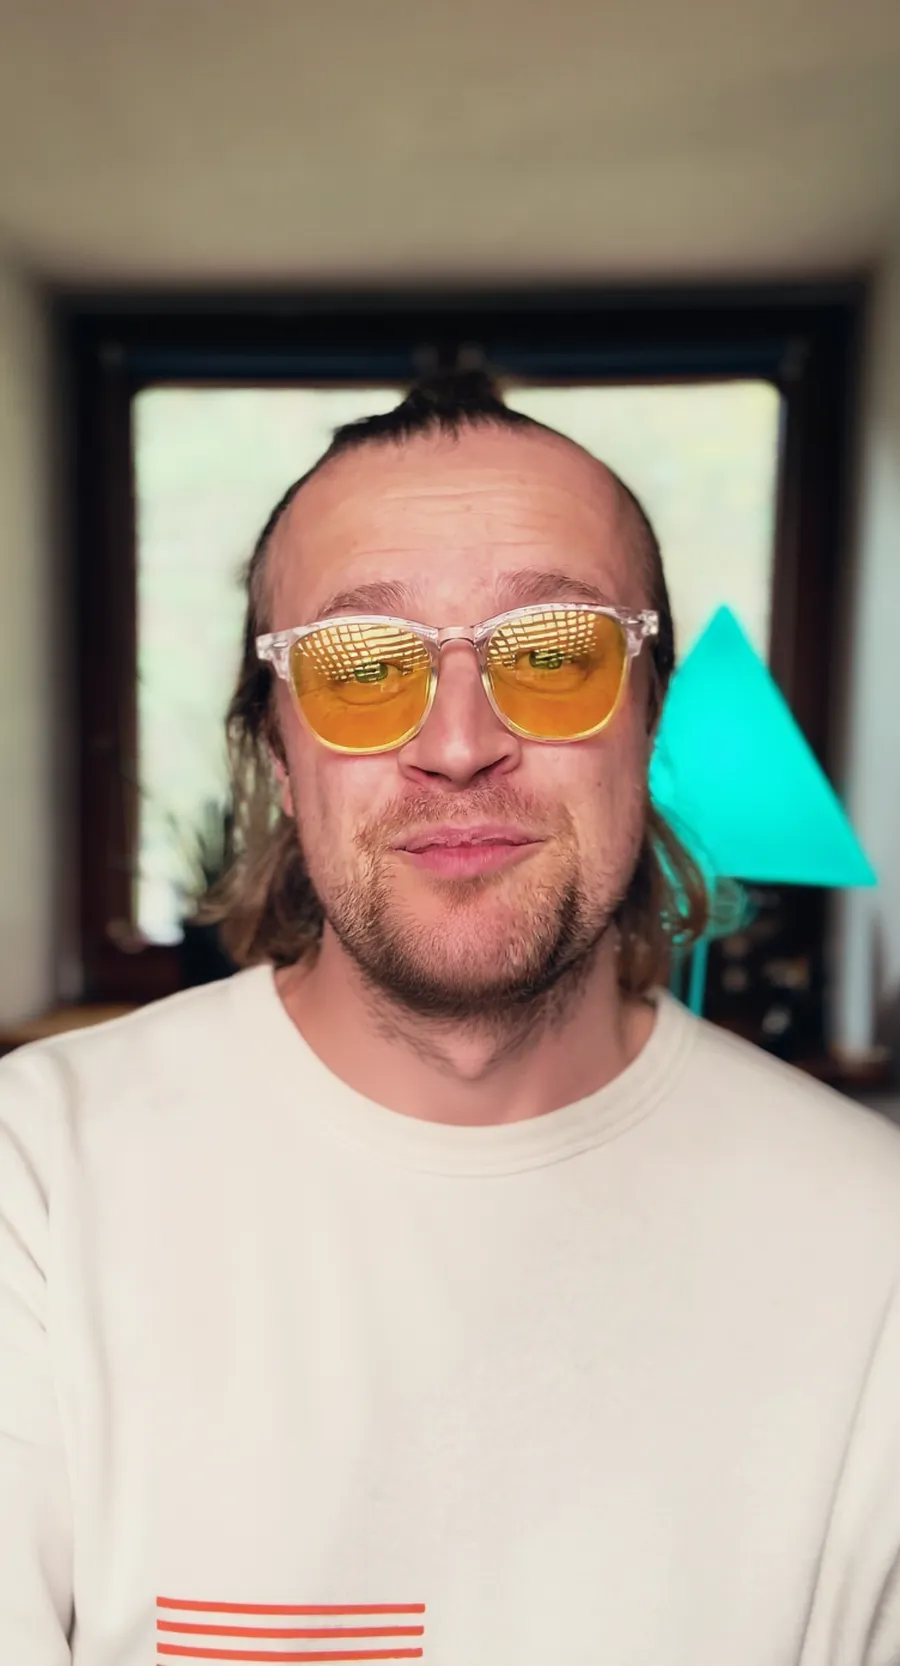 seed 3
Wyniki: czas i pamięć
Jedna edycja klatki trwa na tym Macu około 5,5 minuty. Pierwsza trwała o około 37 s dłużej, bo obejmuje zakodowanie polecenia przez enkodery T5 i CLIP oraz ponowne uruchomienie serwera, które zwalnia pamięć zajętą przez enkoder. Resztę czasu zajmują 24 kroki modelu w wersji Q8.
Pamięci było mało, ale wystarczyło. Przed testem system miał 26,6 GB wolnej pamięci, a w najgorszym momencie 6,0 GB. Plik wymiany nie urósł ponad poziom sprzed testu, bo enkoder i model nie były w pamięci jednocześnie.
Edycja zajęła więc około 20,6 GB z 32 GB, czyli więcej niż sam plik modelu. Poza modelem pamięć zajmują obliczenia na obrazie 752 × 1392 pikseli, VAE i bufory PyTorch. Zostaje 6 GB, co wystarczy na przeglądarkę i edytor tekstu, ale nie na drugi model.
Na 32 GB wersja Q8 to górna granica. W pełnej precyzji (bf16) sam model zająłby około 24 GB i bez podziału pracy na etapy system musiałby używać pliku wymiany. Nie mam porównywalnego pomiaru czasu z projektu z 29.10, więc nie zestawiam tych liczb.
Jak uruchomić Kontext w ComfyUI na Macu
Cały zestaw instaluję w osobnym środowisku Pythona, żeby wersje bibliotek nie mieszały się z innymi projektami. U mnie zadziałała taka kolejność:
Kontext na Macu krok po kroku
- 01ComfyUI i PyTorch z MPSInstaluję ComfyUI w osobnym venv i sprawdzam, że PyTorch widzi kartę graficzną Maca (urządzenie mps).
- 02Węzły GGUFDodatek ComfyUI-GGUF pozwala wczytać model i enkoder T5 w wersji Q8.
- 03Pliki modeli i dyskNajwiększy model Wan (Q6) trzymam na dysku wewnętrznym, bo raz, gdy czytał go z dysku USB, serwer przerwał pracę. Kontext w tym pomiarze czytał pliki z zewnętrznego SSD przez USB bez błędów, a ich wczytanie jest wliczone w podane czasy.
- 04Polecenie osobnoKoduję tekst raz, zapisuję wynik i uruchamiam serwer od nowa, żeby enkoder zwolnił pamięć.
- 05Edycja i podglądKilka ziaren losowości, jeden arkusz z porównaniem i wybór najlepszego wariantu na oko.
Warto też uruchamiać ComfyUI z uwagą SDPA z biblioteki PyTorch (flaga --use-pytorch-cross-attention). Bez tej flagi ComfyUI na Macu używa innej, wolniejszej metody (sub-quadratic). W projekcie zmierzyłem, że uwaga SDPA była na karcie graficznej Maca około trzy razy szybsza przy tej samej pracy. To jedna flaga przy starcie serwera, a skraca każdą edycję i każdy fragment wideo w dalszych etapach.
Polecenie zamiast maski
Klasyczna edycja zdjęcia takim modelem to inpainting: zaznaczasz maską obszar do zmiany i opisujesz, co ma się w nim pojawić. Kontext działa inaczej. Praca Black Forest Labs o Kontext opisuje, że zdjęcie wejściowe trafia do modelu razem z poleceniem, więc ten sam model umie tworzyć obrazy i je edytować, bez maski. Model sam decyduje, które piksele zmienić, na podstawie polecenia. To duża oszczędność czasu: nie muszę obrysowywać dłoni z mikrofonem ani lampy, wystarczy jedno zdanie.
Ma to też wadę. Model może zmienić coś, czego nie wymieniłem, na przykład lekko przesunąć cień albo zmienić odcień ściany. Dlatego zawsze porównuję wynik z oryginałem na suwaku, a twarz oglądam w powiększeniu. W projekcie sprawdzałem też podobieństwo twarzy liczbowo, osobnym modelem, ale przy jednej klatce szybciej i pewniej jest uważnie obejrzeć wynik.
Na co uważać przy edycji klatek
Pierwsza rzecz to proporcje obrazu. Węzeł FluxKontextImageScale w ComfyUI zmienia rozmiar zdjęcia na najbliższą rozdzielczość, z którą pracuje Kontext, i przycina środek kadru. U mnie to 752 × 1392 pikseli, czyli proporcje 0,540 zamiast 0,5625, jakie ma pionowe wideo 9:16. W projekcie klatka startowa wyszła przez to rozciągnięta o 4%, co wyłapałem dopiero przy sprawdzaniu przed pełnym przebiegiem. Wynik trzeba wklejać z powrotem w klatkę dokładnie w miejsce tego wycinka. W porównaniu powyżej przycinam oryginał tak samo, żeby suwak pokazywał te same piksele.
Druga rzecz to wybór ziarna losowości. Każde ziarno daje trochę inną lampę i inaczej wypełnia miejsce po dłoni. W projekcie zrobiłem trzy warianty, obejrzałem je obok siebie i wybrałem ziarno 2. Skrypt mógłby sam wybrać wariant, w którym twarz jest najbardziej podobna do oryginału, ale tu wolę wybrać sam, bo od tej jednej klatki zależy cały film.
Trzecia rzecz to licencja. Według niekomercyjnej licencji FLUX.1 dev:
- wyniki możesz używać w dowolnym celu, także komercyjnym, poza trenowaniem modeli konkurencyjnych wobec FLUX,
- sam model wolno uruchamiać tylko w celach niekomercyjnych,
- wynik musi mieć oznaczenie treści AI tam, gdzie wymaga tego prawo,
- przed każdym udostępnieniem wynik musi przejść filtr treści albo przegląd człowieka.
Dlatego mój test traktuję jako niekomercyjny pomiar modelu. Jeśli chcesz używać Kontextu w pracy zarobkowej albo w usłudze dla klientów, wybierz licencję komercyjną Black Forest Labs (dla Kontextu to płatny dodatek) albo wersję [pro] przez API. Plik Q8 pochodzi z konwersji GGUF przygotowanej przez QuantStack i ma tę samą licencję co oryginał.
Lokalnie czy przez API
Black Forest Labs udostępnia Kontext także przez API, czyli jako płatną usługę w chmurze. Według cennika BFL FLUX.1 Kontext [pro] kosztuje 0,04 USD za obraz, a [max] 0,08 USD. Trzy warianty jednej klatki to więc 12–24 centy. Na własnym Macu nie płacę za obraz, ale płacę czasem: trzy edycje zajęły łącznie 17,4 minuty pracy karty graficznej.
Przy jednej klatce na rolkę wygodniejsze jest API: trzy warianty w Kontext [pro] kosztują około 12 centów, a Mac nie jest zajęty przez 17 minut. Wersja na własnym komputerze ma sens w trzech sytuacjach:
- materiał jest prywatny i nie chcesz go wysyłać na cudze serwery,
- potrzebujesz dziesiątek prób z różnymi poleceniami, które mogą działać w nocy,
- chcesz mieć pełną kontrolę nad schematem w ComfyUI, na przykład wstawić Kontext między inne kroki.
Szerzej o narzędziach do obrazu i wideo piszę w przewodniku o obrazie, wideo i głosie z AI, a o oznaczaniu takich treści w artykule o C2PA i oznaczaniu treści AI.
Werdykt
Kontext zrobił dokładnie to, czego potrzebowałem: zmienił przedmioty i tło, a twarz została rozpoznawalna. Na Macu mini z 32 GB działa stabilnie pod jednym warunkiem: enkoder tekstu i model obrazu pracują po kolei, a nie jednocześnie. Do pojedynczych poprawek wybrałbym API, a do pracy na prywatnym materiale i do wielu prób wersję na własnym komputerze.
W poprzedniej części mierzyłem model językowy Qwen3.6 na Macu mini. Ten test jest niekomercyjny, zgodnie z licencją modelu, a kolejne części serii pojawiają się codziennie.