
- Qwen3.6-35B-A3B ma 35 mld parametrów, ale na każdy token liczy tylko 3 mld, więc na Macu mini z 32 GB działa płynnie w 4 bitach.
- W moim studiu rolek ocenia każdą rolkę w kilka sekund, bez API.
- Tryb myślenia daje lepsze odpowiedzi w trudnych zadaniach, ale kosztuje czas i pamięć: mierzę ile.
To pierwsza część serii, w której testuję każdy lokalny model, którego używałem w moim studiu rolek. Zaczynam od modelu, który rozumiał tam język: Qwen3.6-35B-A3B. Uruchamiam go na Macu mini M6 z 32 GB pamięci, bez chmury i bez klucza API, i mierzę trzy rzeczy, które interesują każdego, kto buduje z AI: jak szybko odpowiada, ile trwa jego myślenie i ile pamięci zjada.
Po co mi lokalny model językowy w studiu rolek
Moje studio rolek to zestaw skryptów, który analizuje krótkie filmy: tnie je na ujęcia, transkrybuje mowę, ogląda kadry, słucha dźwięku i na końcu składa z tego ocenę oraz plan montażu. Większość etapów robią małe, wyspecjalizowane modele. Jeden etap wymaga jednak zrozumienia języka: trzeba przeczytać pierwsze zdania rolki i ocenić, czy otwierają ciekawość, czy drugie zdanie rozwija obietnicę i czy zakończenie zachęca do komentarza. Wcześniej robiły to wyrażenia regularne i proste reguły. Działały słabo, bo nie rozumiały sensu.
Zastąpiłem je Qwenem. Dostaje transkrypcję, opis rolki i tekst z ekranu, a zwraca obiekt JSON z czterema ocenami od 1 do 10, flagą „zakończenie jak z szablonu” i trzema propozycjami tekstu na ekran. Ten etap przeszedł przez wszystkie przebiegi analizy: 255 rolek w pierwszym dużym przebiegu (0 błędów parsowania), potem pulę rozszerzoną do 525 rolek i 47 moich własnych rolek. Na moich rolkach etap oceny trwał w medianie 4,4 s na rolkę. To jest tło tego testu: nie sprawdzam modelu na zagadkach z benchmarków, tylko na zadaniu, które naprawdę wykonywał.
Co to za model i dlaczego mieści się na Macu
Qwen3.6-35B-A3B to model typu Mixture of Experts na licencji Apache 2.0. Według karty modelu na Hugging Face ma 35 mld parametrów, ale dla każdego tokenu aktywuje około 3 mld: z 256 ekspertów włącza 8 wybranych i jednego wspólnego. Dzięki temu liczy jak mały model, a wie jak duży. Natywny kontekst to 262 144 tokeny, a według karty da się go rozszerzyć do około miliona. Ciekawa jest też budowa warstw: na 40 warstw tylko co czwarta używa pełnej, bramkowanej uwagi, a pozostałe liniowej uwagi Gated DeltaNet. To jeden z powodów, dla których długi kontekst nie rośnie w pamięci tak szybko jak w starszych modelach. Model ma też enkoder obrazu, więc ta sama rodzina obsługuje zdjęcia i klatki wideo (to temat piątej części).
Na Macu uruchamiam go przez MLX, bibliotekę Apple do uczenia maszynowego na układach M, i nakładkę mlx-lm do modeli językowych. Na dysku mam dwie wersje 4-bitowe od społeczności MLX. Zwykła 4-bit to prosta kwantyzacja wag. Wersja DWQ (Distilled Weight Quantization, opisana w dokumentacji mlx-lm) po kwantyzacji dostraja skale i przesunięcia, a nauczycielem jest zwykle model bez kwantyzacji (karta tej wersji nie podaje szczegółów). Według tej dokumentacji trwa to dłużej, ale zwykle daje lepsze wyniki. W projekcie tekstową ocenę robiła wersja DWQ, a zwykła 4-bit, skonwertowana przez mlx-vlm, służyła jako model wizyjny.
| 4-bit DWQ | 4-bit | |
|---|---|---|
| Rozmiar wag (sprawdzony na dysku) | 20,66 GB | 20,40 GB |
| Parametry łącznie / aktywne | 35 mld / 3 mld | 35 mld / 3 mld |
| Kwantyzacja | destylowana (DWQ) | zwykła |
| Rola w moim studiu | ocena tekstu rolki | ocena kadrów (wizja) |
| Biblioteka | w teście mlx-lm 0.32.2 | w teście mlx-lm 0.32.2; w studiu mlx-vlm |
Jeśli chcesz policzyć, czy podobny model zmieści się u Ciebie, rachunek opisuję w tekście o tym, co zmieści się na własnym komputerze.
Stanowisko i metoda
| Mac mini M6 (Mac18,5) | |
|---|---|
| Procesor | Apple M6, 12 rdzeni CPU: 2 Super, 4 Performance, 6 Efficiency |
| Grafika | 12 rdzeni GPU, Metal 4 |
| Pamięć | 32 GB zunifikowanej, wspólnej dla CPU i GPU, przepustowość 170 GB/s |
| Dysk | SSD 512 GB (494 GB po sformatowaniu) |
| System | macOS 27.0.1 |
Test powtarzam zawsze tak samo, żeby wyniki dało się porównać między częściami serii:
Jak mierzę Qwena
- 01Ten sam MacMac mini M6, 32 GB, bez innych ciężkich procesów; skrypt czeka, aż maszyna będzie wolna.
- 02Ten sam promptDokładnie ten, którym studio ocenia rolki, na mojej rolce z kanału (3:51, po polsku).
- 03Dwa trybyBez myślenia i z myśleniem, temperatura 0, po 3 przebiegi.
- 04Dwie kwantyzacje4-bit DWQ i zwykłe 4-bit, ładowane osobno.
- 05Zadanie z kodemFunkcja w Pythonie sprawdzana pięcioma moimi testami, z myśleniem i bez (tylko wersja DWQ).
Mierzę czas do pierwszego tokenu, szybkość czytania promptu i generowania (tokeny na sekundę), liczbę tokenów myślenia, czas całej odpowiedzi i szczyt pamięci podawany przez MLX. Biblioteka: mlx-lm 0.32.2. Temperaturę 0 wybrałem świadomie, choć karta modelu zaleca 0,7 bez myślenia i 1,0 z myśleniem (0,6 przy kodzie): w ocenach zależy mi na tym, żeby ta sama rolka dostawała zawsze tę samą ocenę. Lokalne modele warto mierzyć własnymi zadaniami, nie tylko tabelami z benchmarków, o czym piszę w tekście o własnych testach z Inspect i lm-eval. Wszystko zapisuje się do pliku wyników razem z komendą i wersjami, a przebieg nagrywam w prawdziwym oknie Terminala.
Wyniki: szybkość i jakość odpowiedzi

4-bit DWQ 4-bit Ładowanie modelu 4,6 s 4,0 s Pierwszy przebieg bez myślenia 7,3 s (TTFT 4,2 s) 4,4 s (TTFT 2,0 s) Kolejne przebiegi bez myślenia 3,9 s (TTFT 0,8 s) 3,2 s (TTFT 0,8 s) Czytanie promptu (rozgrzany) ok. 1680 tok/s ok. 1720 tok/s Generowanie 49 tok/s 69 tok/s Z myśleniem (mediana z 3) 63,7 s, 2870 tokenów myślenia 39,5 s, 2437 tokenów myślenia Szczyt pamięci (MLX) 21,98 GB 20,83 GB
TTFT to czas do pierwszego tokenu odpowiedzi, czyli głównie czytanie promptu. Najciekawszy wiersz to generowanie: wersja DWQ pisze o 30% wolniej, choć plik ma podobny rozmiar. Wyjaśnienie znalazłem w plikach config.json DWQ i zwykłej 4-bit; liczby bajtów poniżej wyliczam z wymiarów modelu. W zwykłej 4-bit prawie wszystko jest w 4 bitach (w 8 bitach zostaje tylko 80 małych bramek: 40 bramek routera i 40 bramek eksperta wspólnego). W DWQ eksperci są w 4 bitach, ale wszystkie warstwy uwagi (30 liniowych i 10 klasycznych), osadzenia i warstwa wyjściowa są w 8 bitach. Uwagę i warstwę wyjściową model czyta w całości przy każdym tokenie, a ekspertów tylko w 8 z 256. Na każdy token DWQ czyta więc około 2,6 GB wag, a zwykła 4-bit około 1,7 GB, a generowanie na Macu ogranicza głównie szybkość czytania pamięci. Apple podaje dla Maca mini z M6 i 32 GB przepustowość pamięci 170 GB/s, więc przy 1,7 GB na token sufit to około 100 tokenów na sekundę, a ja mierzę 69. Rozmiary plików są podobne, bo eksperci zajmują w obu wersjach po 18,1 GB, a paczka 4-bit zawiera dodatkowo 0,9 GB enkodera obrazu (jej część tekstowa ma 19,5 GB). Na tym Macu to różnica, którą odczujesz: przy ocenie z myśleniem DWQ pracuje około 64 s, a zwykła 4-bit niecałe 40 s.
Pierwszy przebieg po załadowaniu jest zawsze wolniejszy, bo system dociąga wagi z dysku do pamięci i rozgrzewa kernele GPU. Dlatego podaję osobno pierwszy przebieg i medianę z kolejnych. W praktyce studio ładuje model raz na całą partię rolek i ten koszt rozkłada się na setki ocen.
Bez myślenia obie wersje dały identyczne oceny we wszystkich trzech przebiegach: haczyk 3, obietnica 4, ciągłość pętli 6, potencjał komentarzy 7 i flaga „zakończenie jak z szablonu”. Różniły się tylko propozycje tekstu na ekran („Powrót do kodowania z AI” w DWQ i „Dlaczego zniknąłem z Instagrama” w 4-bit). Każda z 12 ocen (6 bez myślenia i 6 z myśleniem) była poprawnym JSON-em, bez ani jednego błędu parsowania. W zadaniu z kodem model miał napisać funkcję, która dzieli transkrypcję na zdania. Bez myślenia odpowiedź była gotowa po 7,4 s i przeszła 4 z 5 moich testów. Poległa na zdaniu „Wersja 2.5 jest szybsza. Serio!”, bo jej wyrażenie regularne nie przechodzi przez kropkę w „2.5”: zgubiła początek „Wersja 2.” i jako pierwsze zdanie zwróciła „5 jest szybsza.”. Z myśleniem model pracował 98 s, wygenerował 4575 tokenów rozumowania i oddał krótszą funkcję, która przeszła wszystkie 5 testów.
Myślenie: kiedy opłaca się czekać
Qwen3.6 potrafi przed odpowiedzią „pomyśleć”, czyli wygenerować tok rozumowania, którego nie pokazuje się w wyniku. To zwykłe tokeny: kosztują czas tak samo jak odpowiedź, a do tego zajmują miejsce w pamięci podręcznej kontekstu. W moim studiu wyłączyłem myślenie przy ocenie rolek. W ocenie według sztywnego schematu myślenie nie poprawiło formatu ani powtarzalności, a wydłużyło odpowiedź kilkunastokrotnie; czy oceny są trafniejsze, nie wiem. JSON bez myślenia był gotowy po kilku sekundach i parsował się bez błędów na 255 rolkach.
Inaczej jest z zadaniami, w których model musi coś zaplanować. Tu najlepiej widać to na nagraniu: model dostaje pytanie o podział pracy między lokalny model a API i zanim odpowie, przez dłuższą chwilę pisze tok rozumowania.

W ocenie rolki wersja DWQ myślała przez 60,6 s i 2870 tokenów, czyli około 10 tysięcy znaków rozumowania przed odpowiedzią z pięcioma liczbami. Zwykła 4-bit myślała krócej: 2437 tokenów w 37,3 s. Myślenie zmieniło też same oceny. Wersja DWQ z myśleniem była surowsza: obietnicę i ciągłość pętli ocenił na 2 zamiast 4 i 6, a potencjał komentarzy na 6 zamiast 7. W 4-bit zmiana była mniejsza (ciągłość 5 zamiast 6). Nie mam wzorca, który powiedziałby, która ocena jest lepsza, ale to ważna lekcja: tryb myślenia nie jest neutralny dla wyniku, więc jeśli porównujesz oceny w czasie, nie przełączaj go w połowie projektu. W kodzie myślenie zrobiło realną różnicę: z 4 na 5 zaliczonych testów, za cenę 13 razy dłuższego czekania.
Praktyczna zasada, którą stosuję: myślenie włączam tam, gdzie błąd jest drogi, a odpowiedź nie jest sztywnym formularzem. Do klasyfikacji, ocen i wyciągania pól z tekstu wyłączam je i zamiast tego dokładnie opisuję w promptcie skalę i każde pole (5 to przeciętna rolka, 9–10 tylko najlepsze 5%).
Pamięć: 32 GB to mniej, niż się wydaje
Same wagi to 20,66 GB. Do tego dochodzi pamięć na kontekst, która rośnie z każdym przeczytanym i wygenerowanym tokenem, oraz to, czego potrzebuje system i inne aplikacje. W projekcie przekonałem się o tym boleśnie: przy analizie jednej rolki skrypt ładował wersję wizyjną Qwena obok tekstowej i Metal kończył pracę błędem braku pamięci. Poprawka była prosta (duży model zwalnia drugi przed załadowaniem), ale pokazuje regułę: na 32 GB mieści się jeden duży model naraz.
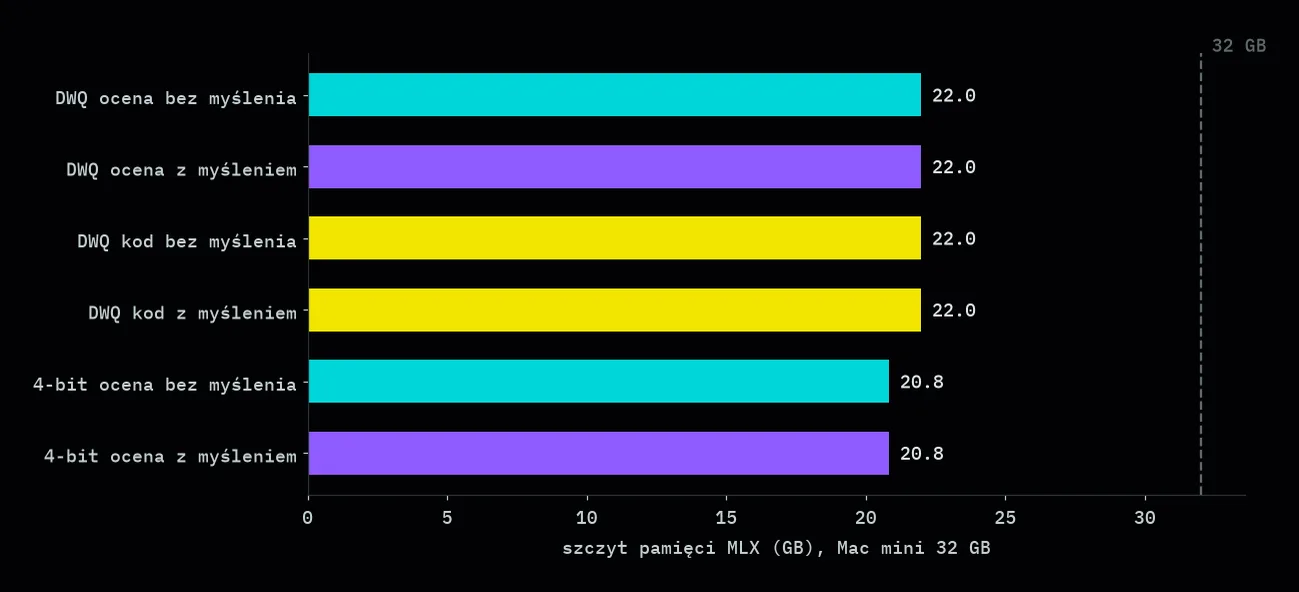
Szczyt pamięci według MLX wyniósł 21,98 GB dla DWQ i 20,83 GB dla 4-bit, niezależnie od tego, czy model myślał. Długie myślenie nie podniosło szczytu, bo przy 4–5 tysiącach tokenów pamięć podręczna kontekstu jest mała wobec 20 GB wag, a większość warstw Qwena używa uwagi liniowej, której pamięć nie rośnie z długością tekstu. Sam proces Pythona miał w szczycie do 12,9 GB, bo MLX trzyma wagi w buforach Metal, których licznik pamięci procesu nie obejmuje w całości. Przy szczycie około 22 GB zostaje na 32 GB około 10 GB na system i aplikacje. To wystarcza do pracy z jednym dużym modelem, ale nie wystarcza, żeby obok trzymać drugi model tej wielkości. Po zwolnieniu DWQ system pokazywał tylko 9,4 GB wolnej pamięci (na starcie 23,6 GB), swap urósł z 2,95 do 3,41 GB, a mimo to wersja 4-bit załadowała się i przeszła wszystkie przebiegi bez błędu braku pamięci. Zasada, że ładuję jeden duży model naraz, wynika z błędu z projektu, nie z tego pomiaru.
Lokalnie czy przez API: rachunek na moich rolkach
Lokalny model nie ma rachunku za tokeny, ale nie jest darmowy: kosztuje czas Maca i jego zakup. Żeby porównać to uczciwie, liczę, ile kosztowałaby ta sama ocena przez API. Według cennika Anthropic Claude Haiku 5.5 kosztuje 0,10 USD za milion tokenów wejściowych i 0,50 USD za milion wyjściowych (dla promptów do 100 000 tokenów). Według cennika Google Gemini 3.5 Flash-Lite to 0,30 USD za wejście i 2,50 USD za wyjście.
| Czas | Koszt | |
|---|---|---|
| Qwen 4-bit DWQ lokalnie (3,9 s na ocenę) | ok. 34 min | 0 USD za wywołania |
| Qwen 4-bit lokalnie (3,2 s na ocenę) | ok. 28 min | 0 USD za wywołania |
| Claude Haiku 5.5 (0,10 / 0,50 USD za MTok) | zależny od sieci | ok. 0,11 USD |
| Gemini 3.5 Flash-Lite (0,30 / 2,50 USD za MTok) | zależny od sieci | ok. 0,41 USD |
Jedna ocena to 1361 tokenów wejścia i 152–164 tokeny wyjścia, więc 525 ocen to około 715 tysięcy tokenów wejścia i 80 tysięcy wyjścia. W Batch API Anthropic, gdzie wynik przychodzi zwykle w ciągu godziny, Haiku 5.5 kosztuje połowę, czyli około 0,06 USD. Gemini 3.5 Flash-Lite w trybie wsadowym kosztuje 0,15/1,25 USD za milion tokenów, czyli około 0,21 USD. Przy darmowym planie Gemini cennik zaznacza, że dane służą do ulepszania usług Google, co przy cudzych materiałach jest dodatkowym argumentem za modelem lokalnym. Tokeny liczę tokenizerem Qwena, a każdy dostawca API ma własny tokenizer, dlatego koszt API to szacunek. Liczę bez myślenia, bo z myśleniem wyjście rośnie 16–20 razy.
Z tego rachunku wychodzi coś, co powtarza się w całej serii: przy prostych, powtarzalnych ocenach tanie API kosztuje grosze, więc lokalny model nie wygrywa ceną. Wygrywa czymś innym. Dane nie wychodzą z komputera, nie ma limitów zapytań ani zmian cennika w trakcie projektu, a ten sam model mogę puścić na tysiąc rolek w nocy bez myślenia o fakturze. Więcej o liczeniu kosztu zadania piszę w tekście o koszcie zadania w tokenach.
Werdykt
Qwen3.6-35B-A3B to dziś mój domyślny lokalny model do pracy z tekstem na Macu z 32 GB. Jest wystarczająco szybki do ocen w pętli, rozumie polski i trzyma format JSON. Myślenie włączam tylko tam, gdzie zadanie tego wymaga, i pilnuję, żeby obok niego nie wisiał drugi duży model.
W kolejnych częściach testuję resztę modeli z mojego studia: edycję obrazu, transkrypcję, mówiącego awatara i modele, które oglądają i słuchają rolek. Chcesz taki lokalny pipeline u siebie, dopasowany do Twoich treści? Zobacz, jak pracuję przy automatyzacjach i agentach AI.