
- Awatar z Wana powstaje w 432 × 768, a rolka potrzebuje co najmniej 1080 × 1920.
- Lanczos tylko rozciąga piksele, Real-ESRGAN wyostrza krawędzie, a SeedVR2 dorysowuje fakturę skóry i rzęsy.
- W projekcie SeedVR2 liczony tylko na wycinku głowy zajął około 87 minut na rolkę 48 s, a na całej klatce zająłby prawie 4 h.
W szóstej części serii zajmuję się problemem, który pojawia się przy każdym wideo z AI tworzonym na własnym komputerze: generator daje mały obraz. Mówiący awatar z czwartej części powstaje w rozdzielczości 432 × 768 pikseli. Pionowa rolka potrzebuje co najmniej 1080 × 1920, a wersja końcowa w 4K jeszcze więcej. Porównuję cztery sposoby powiększania na Macu mini M6 z 32 GB: zwykłe skalowanie metodą Lanczos, Real-ESRGAN oraz SeedVR2 w wersjach 3B i 7B. Patrzę na czas, pamięć i to, co widać na zbliżeniu twarzy.
Dlaczego zwykłe powiększenie nie wystarcza
Powiększenie obrazu 2,5 raza oznacza, że na każdy piksel oryginału przypada ponad sześć pikseli wyniku. Metoda powiększania musi je czymś wypełnić. Lanczos, klasyczna metoda dostępna w każdym programie graficznym i w ffmpeg, liczy każdy nowy piksel jako gładką średnią pikseli dookoła. Krawędzie zostają w miarę ostre, ale skóra, rzęsy i włosy zamieniają się w miękką plamę. Na telefonie widać to od razu, bo twarz zajmuje w rolce dużą część ekranu.
Modele AI do powiększania działają inaczej: dorysowują szczegóły, które pasują do tego, co widzą.
Real-ESRGAN to sieć konwolucyjna, którą uczono na zdjęciach celowo pogorszonych: rozmytych, zaszumionych i mocno skompresowanych. Wyostrza krawędzie i usuwa ślady kompresji.
SeedVR2 idzie dalej. Według pracy autorów to model dyfuzyjny do poprawiania wideo w jednym kroku, dodatkowo wzmocniony treningiem adwersarialnym. Patrzy na kilka klatek naraz, dzięki czemu dorysowane szczegóły nie skaczą z klatki na klatkę.
Jak to robiłem w projekcie
W moim zestawie narzędzi do awatara powiększanie miało cztery tryby. Domyślny tryb, nazwany „seedface”, działa tak:
- SeedVR2 liczy tylko wycinek z głową,
- resztę kadru powiększa Lanczos,
- powiększona twarz jest wklejana w kadr przez maskę z miękką krawędzią.
Wycinek to około jedna trzecia klatki. Przy powiększeniu 2,0 model liczy więc prawie pięć razy mniej pikseli niż na całej klatce, a czas pracy SeedVR2 rośnie z liczbą pikseli. Tryb na całej klatce oszacowałem z próbki 21 klatek na prawie 4 h dla rolki 48 s. Tryb seedface zajął w nocnym przebiegu około 87 minut, razem z ponownym uruchomieniem procesu w trakcie.
| Co robi | Czas na rolkę 48 s | |
|---|---|---|
| Lanczos | skaluje całą klatkę (ffmpeg) | sekundy |
| Real-ESRGAN x4 | sieć liczy każdą klatkę osobno | ok. 75 min (szacunek z 21 klatek) |
| SeedVR2 3B, wycinek głowy | dyfuzja na twarzy, reszta Lanczos | ok. 87 min |
| SeedVR2 na całej klatce | dyfuzja na całym kadrze | ok. 3,8 h (szacunek z 21 klatek) |
W rolce z awatarem różnicę było widać od razu. Wersja tylko z Lanczosem była miększa: twarz wyglądała jak lekko nieostre wideo z kamerki internetowej. Wersja seedface miała fakturę skóry i wyraźniejsze oczy.
Ma to jednak skutek uboczny, który zmierzyłem: szum czasowy twarzy wzrósł do 1,49 raza względem mojego prawdziwego nagrania. To tuż pod progiem 1,5, który sam przyjąłem. SeedVR2 dodaje fakturę, która przy uważnym oglądaniu lekko pulsuje.
Modele i ustawienia w teście
| Lanczos | Real-ESRGAN | SeedVR2 3B | SeedVR2 7B | |
|---|---|---|---|---|
| Rodzaj | metoda bez AI | sieć konwolucyjna | dyfuzja, 1 krok | dyfuzja, 1 krok |
| Plik modelu | brak | 67 MB | 3,7 GB (Q8) + VAE 0,5 GB | 4,8 GB (Q4, sharp) + VAE 0,5 GB |
| Gdzie liczy | procesor (ffmpeg) | karta graficzna (ComfyUI) | karta graficzna (ComfyUI) | karta graficzna (ComfyUI) |
| Licencja | – | BSD-3 | Apache 2.0 | Apache 2.0 |
SeedVR2 uruchamiam w ComfyUI przez dodatek ComfyUI-SeedVR2_VideoUpscaler, który wczytuje pliki w formacie GGUF. Real-ESRGAN uruchamiam przez standardowy węzeł powiększania z modelem x4plus z repozytorium Real-ESRGAN.
Wersja 7B ma wariant „sharp”, nastawiony na mocniejsze wyostrzanie. Wybrałem ten wariant w wersji po kwantyzacji Q4 (4,8 GB), czyli plik Q4_K_M z paczki AInVFX. Większych wersji z repozytorium numz (FP8 8,2 GB, FP16 16,5 GB) nie uruchamiałem.
Na czym i jak mierzę
| Mac mini M6 (Mac18,5) | |
|---|---|
| Procesor | Apple M6, 12 rdzeni CPU: 2 Super, 4 Performance, 6 Efficiency |
| Grafika | 12 rdzeni GPU, Metal 4 |
| Pamięć | 32 GB pamięci wspólnej dla procesora i grafiki, przepustowość 170 GB/s |
| Dysk | SSD 512 GB (494 GB po sformatowaniu) |
| System | macOS 27.0.1 |
Na wejściu jest 100 klatek mówiącego awatara z czwartej części (Wan 2.1 Q6, 432 × 768). Każdą metodą powiększam je do 1080 × 1920. SeedVR2 liczę w trybie seedface na wycinku głowy, tak jak w projekcie: model powiększa wycinek 2 razy, a do pełnej rozdzielczości resztę dociąga Lanczos.
Mierzę:
- czas całego etapu,
- czas na jedną klatkę,
- najmniejszą ilość wolnej pamięci i rozmiar pliku wymiany.
Do porównania wycinam z każdego wyniku ten sam kwadrat z twarzą ze środkowej klatki. Pomiar robię na Macu, na którym nie działają inne ciężkie programy. Osobny, pojedynczy przebieg nagrałem w prawdziwym oknie Terminala.

Wyniki: zbliżenia
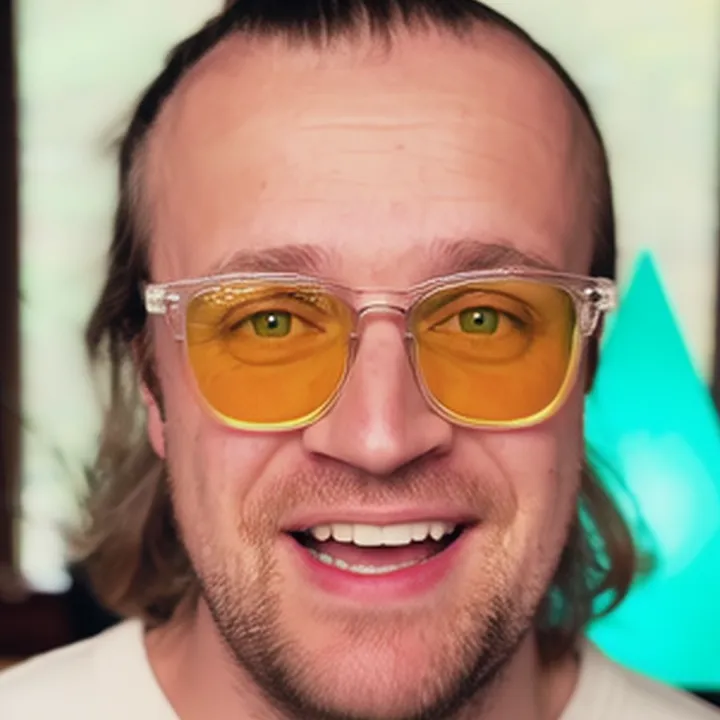
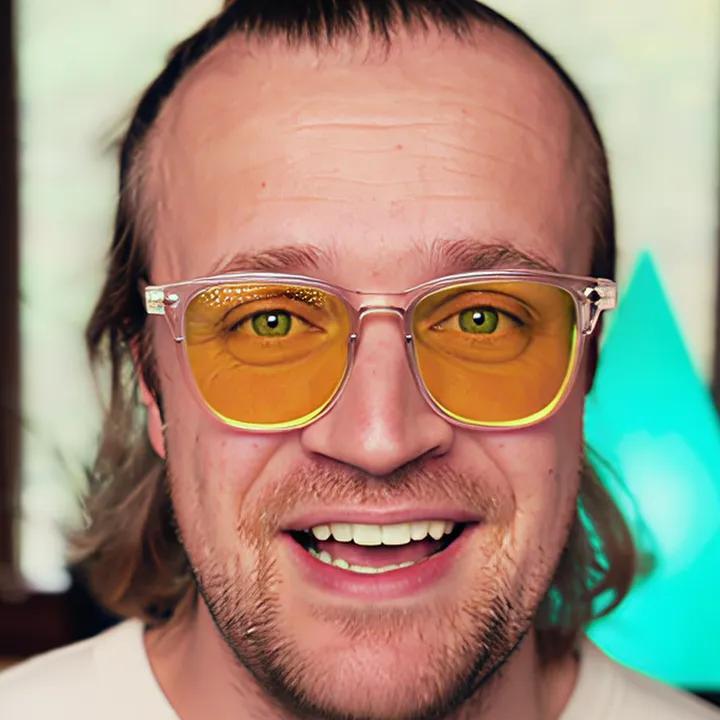
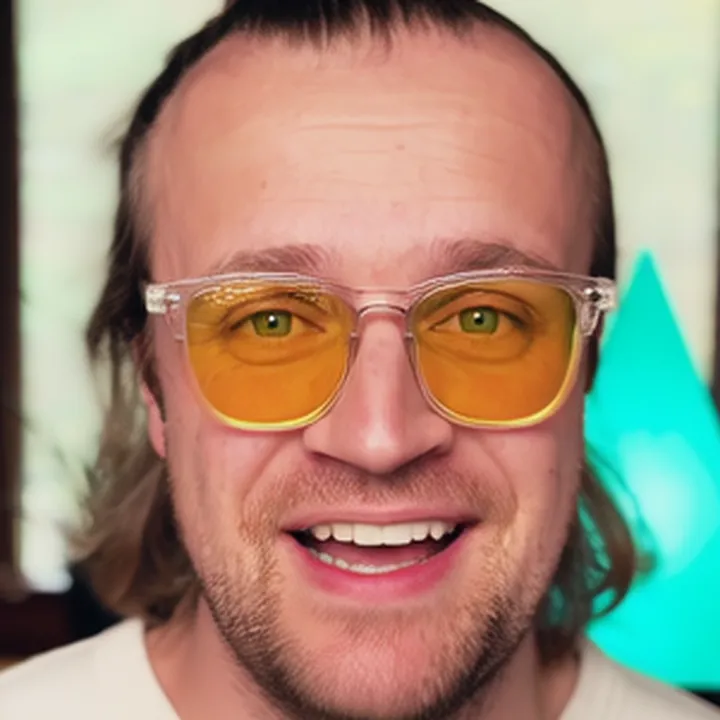 źródło (powiększone do podglądu)Lanczos
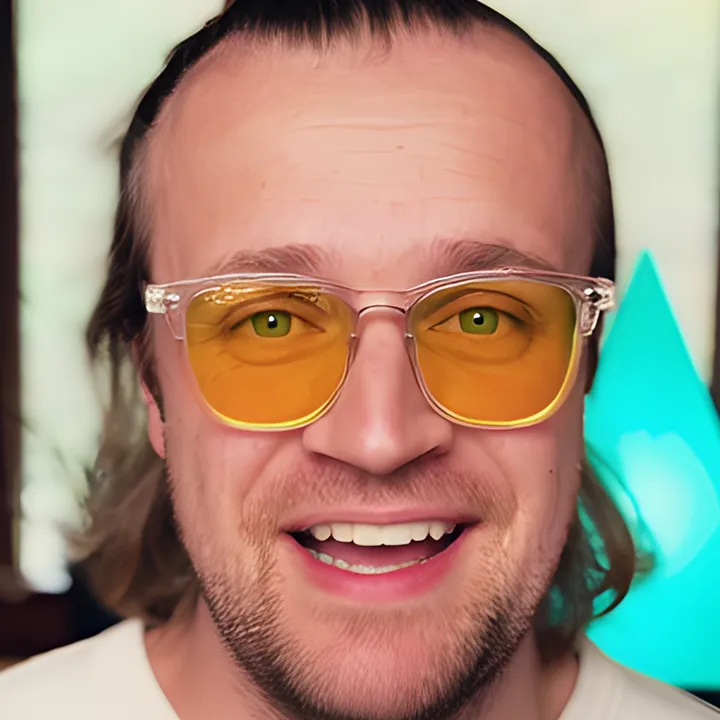 ESRGANSeedVR2 3B
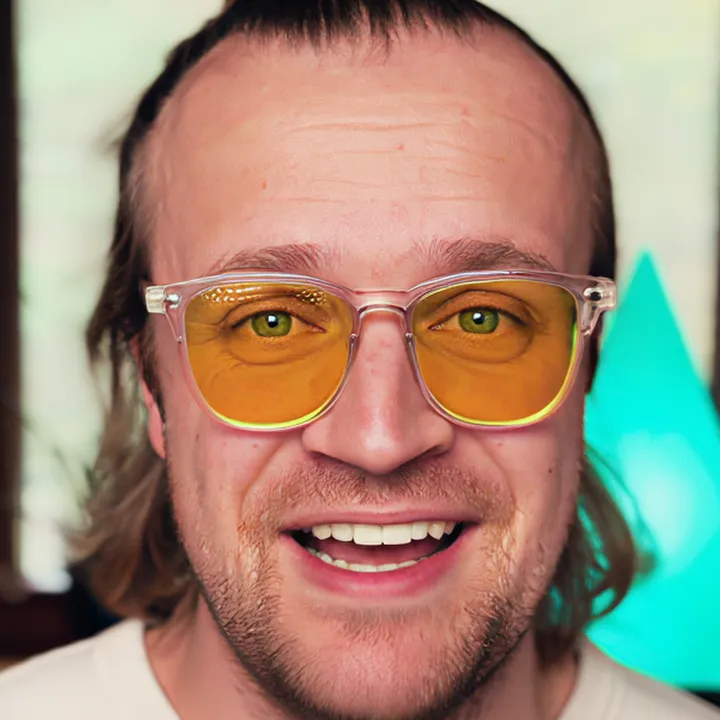 SeedVR2 7B
Różnice widać od razu w okolicy oczu i ust:
- Lanczos tylko rozciąga piksele: rzęsy i zarost zlewają się w miękką plamę, a krawędź okularów jest rozmyta.
- Real-ESRGAN wyostrza krawędzie oprawek i tęczówek, ale skórę czoła i policzków wygładza tak, że wygląda jak z wosku, a zarost zamienia w rozmazane kreski. Daje też obraz 1728 × 3072, czyli 2,5 raza więcej pikseli, niż potrzeba, więc potem go zmniejszam. To typowe zachowanie tego modelu przy twarzach.
- SeedVR2 3B jako jedyny odtwarza fakturę: widać pojedyncze włoski zarostu, wyraźne rzęsy, linie oprawek i drobne zmarszczki pod oczami.
- SeedVR2 7B ma płytsze bruzdy, mniej plamek i zęby bez zielonego odcienia, więc jest wierniejszy od 3B, choć z daleka oba wyglądają podobnie.
SeedVR2 3B część szczegółów dorysował mocniej, niż było ich w klatce źródłowej: bruzdy na czole, czerwone plamki na policzkach i ciemne punkty przy mostku okularów. Skóra i przezroczyste oprawki zrobiły się bardziej różowe, a dolne zęby mają zielonkawy odcień. Więcej szczegółów nie zawsze oznacza więc większą wierność oryginałowi.
Wyniki: czas i pamięć
| 100 klatek | Na klatkę | Rolka 48 s (1451 klatek) | Najmniej wolnej pamięci | |
|---|---|---|---|---|
| Lanczos (ffmpeg, procesor) | 4,4 s | 0,04 s | ok. 1 min | nie dotyczy |
| Real-ESRGAN x4plus | 306,9 s | 3,07 s | ok. 74 min | 11,5 GB |
| SeedVR2 3B Q8, wycinek głowy | 294,1 s | 2,94 s | ok. 71 min | 7,0 GB |
| SeedVR2 7B sharp Q4, wycinek głowy | 326,2 s | 3,26 s | ok. 79 min | 7,2 GB |
Plik wymiany przez cały test miał 3,0 GB, tyle samo co przed pomiarem, więc żadna metoda nie przekroczyła 32 GB pamięci.
Gdzie naprawdę idzie czas SeedVR2? Dziennik ComfyUI dzieli każdy przebieg na etapy. Sam model, czyli jeden krok dyfuzji na sześciu porcjach po 21 klatek, zajął w wersji 3B około 56 s (z tego około 7 s wczytywania), a w wersji 7B około 84 s. Resztę zajmuje VAE, czyli część, która zamienia klatki na skompresowany zapis i z powrotem na piksele:
- kodowanie trwało około 69 s,
- dekodowanie po kafelkach 512 × 512 trwało aż około 158 s,
- oba etapy trwały tyle samo dla 3B i 7B.
Dlatego 7B jest wolniejszy tylko o 11%, choć sam model liczy o około 50% dłużej (84 wobec 56 s, a bez wczytywania około 84 wobec 49 s).
Wczytywanie modeli to drobiazg. Wszystkie pliki, czyli Real-ESRGAN (67 MB), VAE (0,5 GB) i SeedVR2 (3,7 i 4,8 GB), ComfyUI czytał prosto z mojego zewnętrznego dysku SSD przez USB, a przeniesienie modelu do pamięci karty graficznej trwało kilka sekund.
Jeśli chcesz przyspieszyć SeedVR2 na Macu, szukaj oszczędności w VAE: mniejszy wycinek, mniejsze powiększenie liczone przez model albo większe kafelki, jeśli wystarczy pamięci. Wybór między 3B a 7B niewiele zmienia w czasie.
Zgadza się to z pracą autorów: wersja 3B powstała przez destylację wersji 7B i według nich daje porównywalne wyniki przy połowie rozmiaru. Oficjalne pliki, także wariant sharp, są na karcie SeedVR2-7B, a wersje GGUF pobrałem z repozytorium AInVFX. Model rozwija pierwszą wersję SeedVR.
Na tym Macu 7B kosztuje niewiele więcej: jest o 11% wolniejszy od 3B, zostawia tyle samo wolnej pamięci, a na zbliżeniu daje wierniejszą twarz. Porównanie nie jest jednak czyste, bo 7B to wariant sharp w wersji Q4, a 3B to wariant zwykły w Q8. W badaniu autorów, w którym oceniali ludzie, częściej wybierano 3B niż 7B.
Ciekawe jest porównanie z Real-ESRGAN: SeedVR2 3B na samym wycinku głowy jest minimalnie szybszy niż ESRGAN na całej klatce, bo liczy dużo mniej pikseli. To najlepszy argument za trybem seedface.
W przeliczeniu na rolkę 48 s wersja 3B daje około 71 minut, mniej niż 87 minut z nocnego przebiegu w projekcie. Przeliczenie zakłada, że wczytywanie modeli rozkłada się na całą rolkę tak samo jak na 100 klatek w teście. Ustawień z nocnego przebiegu nie odtworzyłem co do szczegółu, więc obie liczby traktuję jako przybliżenie: od godziny do półtorej.
Lokalnie czy przez API
Na fal.ai powiększanie SeedVR kosztuje 0,001 USD za megapiksel wideo, liczony jako szerokość razy wysokość razy liczba klatek. Rolka 48 s w 1080 × 1920 przy 30 klatkach na sekundę to 1451 klatek po 2,07 megapiksela, czyli około 3000 megapikseli i około 3 USD. Na Macu tryb seedface, który liczy tylko twarz, zajął w projekcie około 87 minut.
Przy jednej rolce różnica w pieniądzach jest mała: około 3 USD przez API wobec 70–90 minut pracy Maca (w teście i w projekcie). Strona fal.ai nie podaje, czy używa wersji 3B czy 7B, a API powiększa całą klatkę.
Wersja na własnym komputerze wygrywa w dwóch sytuacjach:
- materiał jest prywatny,
- chcesz decydować, gdzie model dorysowuje szczegóły, na przykład liczyć go tylko na twarzy, jak w trybie seedface. Zwykłe API tego nie umożliwia.
Na co uważać
Modele powiększające dorysowują szczegóły, których nie było. Przy twarzy to zaleta, bo skóra wygląda naturalnie. Przy tekście, logo czy liczbach na ekranie mogą jednak zmienić kształt liter. Dlatego karty z napisami w moich rolkach powstają od razu w docelowej rozdzielczości, a powiększam tylko obraz z kamery albo z generatora.
Druga rzecz to spójność w czasie. Model, który liczy każdą klatkę osobno, tak jak Real-ESRGAN, może powodować lekkie migotanie szczegółów, bo każda klatka dostaje trochę inne szczegóły. W moim ustawieniu SeedVR2 dostaje porcje po 21 klatek, które zachodzą na siebie o 3 klatki. To zmniejsza problem, ale go nie usuwa.
Szerzej o wyborze między jakością a czasem w wideo z AI piszę w przewodniku o obrazie, wideo i głosie z AI.
Jak złożyć twarz z powrotem w klatkę
Tryb seedface brzmi prosto: twarz powiększa model, a resztę zwykłe skalowanie. Najtrudniejsze jest sklejenie tych dwóch części. Robię to w trzech krokach:
- wycinek z głową ustalam raz dla całego fragmentu, na podstawie kilkudziesięciu klatek, i powiększam go o margines, żeby ruch głowy nie wychodził poza ramkę,
- model liczy tylko ten wycinek,
- wynik wklejam w klatkę powiększoną Lanczosem przez maskę z miękką krawędzią: w środku pełne przykrycie, a przy brzegach łagodne przejście na kilku procentach szerokości wycinka.
Maska z miękką krawędzią jest tu konieczna. Bez niej na granicy wycinka widać wyraźną zmianę faktury, bo twarz jest ostra, a policzek tuż obok miękki. Z maską przejście ginie w naturalnym spadku ostrości wokół twarzy.
W projekcie SeedVR2 liczy też mniejsze powiększenie niż docelowe, a resztę dociąga Lanczos. Czas pracy modelu rośnie z liczbą pikseli, więc powiększenie 2,0 zamiast pełnych 2,5 skraca obliczenia, a na telefonie różnicy nie widać.
Werdykt
Do roboczych wersji rolki liczę SeedVR2 3B tylko na wycinku głowy. Do wersji końcowej warto użyć 7B sharp: za około 8 minut więcej na rolkę dał wierniejszą twarz, bez zielonych zębów i plamek. To kompromis między jakością pełnego SeedVR2 a szybkością Lanczosa. Real-ESRGAN zostawiam do pojedynczych zdjęć i grafik, a Lanczos do tła i elementów, na które nikt nie patrzy z bliska.
Cały proces tworzenia wideo z AI, od klatki startowej do wersji końcowej w 4K, mogę przećwiczyć z Tobą na warsztatach AI 1:1. Edycję klatki zrobiłbym wtedy przez API, bo FLUX.1 Kontext dev ma licencję niekomercyjną.