
- Stable Audio Open zamienia opis tekstowy w kilkusekundowy dźwięk stereo 44,1 kHz: szum przejścia, uderzenie, odgłosy lasu.
- Tworzę po trzy wersje, a model CLAP wybiera tę, która najlepiej pasuje do opisu.
- Model jest darmowy dla twórców z przychodem poniżej 1 mln USD rocznie, a płatna usługa kosztuje kilka centów za dźwięk.
W ósmej części serii zostawiam obraz i przechodzę do dźwięku. Rolka bez efektów brzmi płasko: cięcie bez szumu przejścia, plansza bez lekkiego uderzenia, scena w lesie bez ptaków. Stable Audio Open to otwarty model, który zamienia opis tekstowy w kilkusekundowy dźwięk. Używałem go w mojej animowanej rolce Few Summers do efektów (kroki na drewnianej kładce, uderzenie siekiery, śmiech dzieci) i podkładu fortepianowego, a najlepszą wersję wybierał mi model CLAP. Odgłosy otoczenia wziąłem tam z nagrań terenowych z paczek Sonniss GDC, z których można korzystać bez opłat. Testuję to na Macu mini M6 z 32 GB.
Skąd brać efekty dźwiękowe
Mam trzy źródła efektów:
- Gotowe biblioteki na licencji CC0. Z nich zbudowałem zestaw efektów do szablonu rolek: kilka szumów przejścia, uderzeń, narastających dźwięków i kliknięć z Freesound i Kenney.
- Dźwięki liczone wprost z kodu. Tak powstaje na przykład szum serwera albo stukanie klawiatury.
- Model, który tworzy dźwięk z opisu. Robi dźwięk, którego nie ma w żadnej bibliotece, na przykład „spokojny nocny las z cichym wiatrem i odległymi świerszczami” albo „szybki, kinowy szum przejścia, bez muzyki”.
Licencja CC0 oznacza, że autor zrzekł się praw, więc takie dźwięki mogę używać w rolkach bez podawania autora.
| Biblioteka CC0 | Dźwięk z kodu | Stable Audio Open | |
|---|---|---|---|
| Skąd | Freesound, Kenney | kod (generator sygnału) | model z opisu tekstowego |
| Przewidywalność | wysoka | pełna | zmienna, kilka wersji |
| Czas przygotowania | szukanie i odsłuch | pisanie kodu | około 2 min na wersję (Mac mini M6) |
| Licencja | CC0 (bez podawania autora) | moja | Community: darmowa do 1 mln USD przychodu |
| Najlepsze do | szumy, uderzenia, kliknięcia | szum serwera, stukanie | krótkie efekty, których nie ma w bibliotekach (kroki na kładce, siekiera, śmiech dzieci) |
Stable Audio Open zajął w moim projekcie miejsce tego trzeciego źródła. Według pracy autorów to otwarty model, który zamienia tekst w dźwięk stereo 44,1 kHz i był uczony na nagraniach z licencjami Creative Commons. To model dyfuzyjny: zaczyna od szumu i w kolejnych krokach dochodzi do dźwięku zgodnego z opisem. Plik modelu zajmuje około 5 GB, a model działa w bibliotece diffusers na karcie graficznej Maca.
Jak tworzyłem dźwięki w Few Summers
Few Summers to krótka animowana historia, w której każda scena ma własne tło dźwiękowe. Ustawienia, które zostały do wersji końcowej:
Mój proces tworzenia efektu
- 01Opis po angielskuCo ma brzmieć, jaki ma mieć charakter i czego ma nie być (bez muzyki, bez mowy).
- 02Negatywny promptNiska jakość, zniekształcenia, szum, przester, mowa.
- 03Dwie wersje (w teście trzy)70 kroków dla efektów, 100 dla podkładu muzycznego.
- 04Ocena CLAPKażda wersja dostaje wynik zgodności z opisem.
- 05Wybór albo odrzucenieZostaje najlepsza; poniżej 0,20 druga seria z dopiskiem „clean, natural, realistic”, a potem efekt odpada.
Negatywny prompt to druga część polecenia, w której wypisuję, czego w dźwięku ma nie być. Model stara się wtedy omijać te cechy.
Jedna rzecz wymagała poprawki w kodzie. Próbnik, czyli część modelu, która decyduje, jak usuwać szum w kolejnych krokach, zapętlał się przy ostatnim kroku. Pochodził z biblioteki, z której korzysta diffusers. Zastąpiłem jego źródło losowości zwykłym szumem z ustalonym ziarnem losowości. Dla tego próbnika to równie poprawne źródło losowości, a do tego daje powtarzalne wyniki. Od tej pory tworzenie dźwięków działało stabilnie.
CLAP jako sędzia
CLAP to model, który zamienia dźwięk i tekst na liczby w tej samej przestrzeni. Im bliżej siebie leżą, tym bardziej dźwięk pasuje do opisu. To dobry automatyczny sędzia: nie muszę odsłuchiwać dziesiątek wersji, bo model wskazuje kandydata, a ja słucham tylko wybranej.
We wczesnym przebiegu projektu wynik zgodności dla ptaków w lesie wyniósł 0,251, powyżej mojego progu 0,20. Projekt porównywał dźwięk z krótką etykietą, a ten test z pełnym opisem, więc tych liczb nie warto ze sobą porównywać.
Trzeba pamiętać, że CLAP ocenia zgodność z opisem, a nie jakość nagrania. Dźwięk z trzaskami może dostać wysoki wynik, jeśli brzmi „bardzo leśnie”. Dlatego CLAP odsiewa wersje, ale ostateczną decyzję podejmuję, słuchając.
Na czym i jak mierzę
| Mac mini M6 (Mac18,5) | |
|---|---|
| Procesor | Apple M6, 12 rdzeni CPU: 2 Super, 4 Performance, 6 Efficiency |
| Grafika | 12 rdzeni GPU, Metal 4 |
| Pamięć | 32 GB pamięci wspólnej dla procesora i grafiki, przepustowość 170 GB/s |
| Dysk | SSD 512 GB (494 GB po sformatowaniu) |
| System | macOS 27.0.1 |
Test powtarza ustawienia z projektu na czterech typowych opisach do rolek:
- szum przejścia (2,5 s),
- kinowe uderzenie (3 s),
- stukanie klawiatury (6 s),
- tło dźwiękowe nocnego lasu (10 s).
Dla każdego opisu tworzę trzy wersje w 70 krokach, mierzę czas i liczę wynik CLAP. Na czas testu kopiuję plik modelu z zewnętrznego dysku na wewnętrzny, bo modele czytane z dysku USB potrafiły przerwać pracę błędem. Pomiar robię na Macu, na którym nie działają inne ciężkie programy. Osobny, pojedynczy przebieg nagrałem w prawdziwym oknie Terminala.

Wyniki: posłuchaj
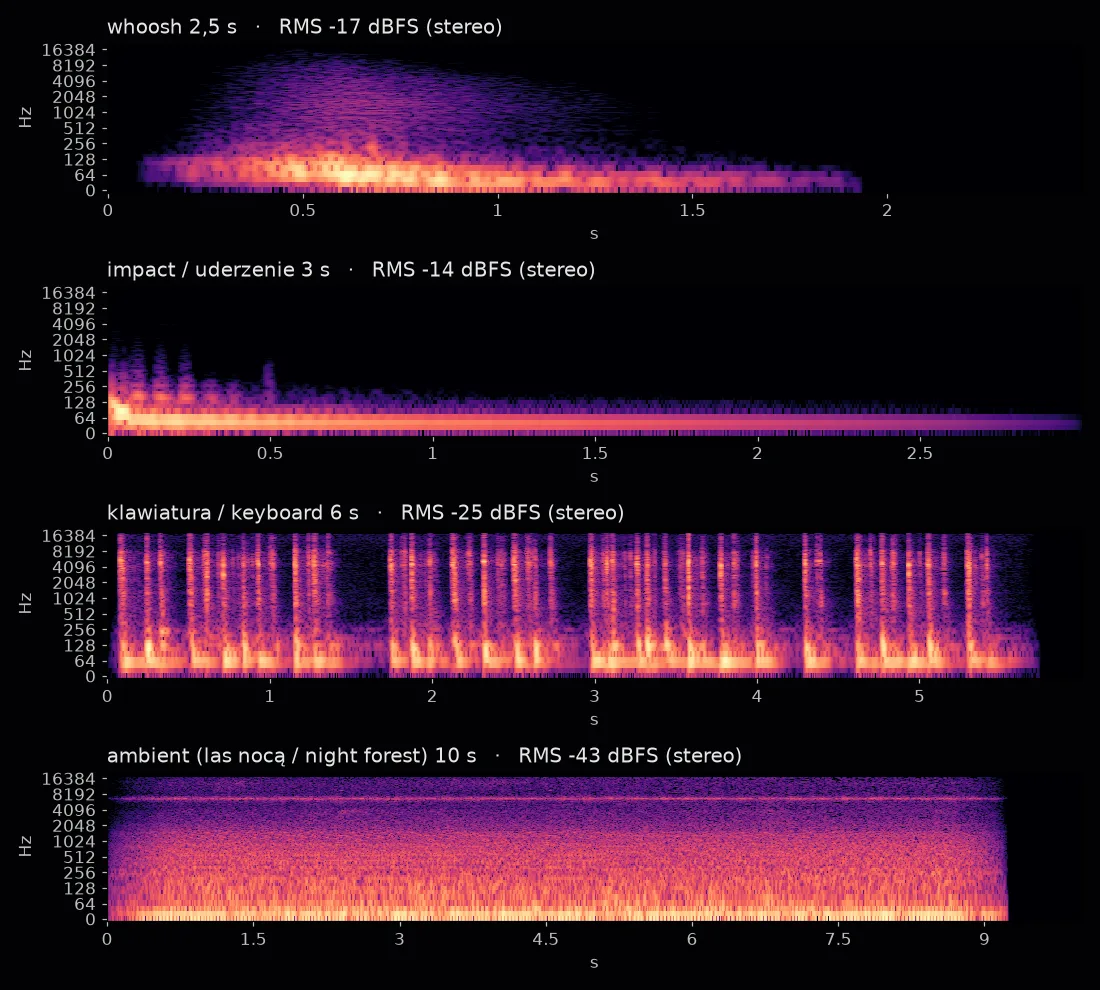
Opis każdego efektu opieram na spektrogramie i pomiarach głośności wybranej wersji, którą możesz odsłuchać wyżej. Spektrogram to obraz dźwięku: oś pozioma to czas, pionowa wysokość dźwięku, a jasność głośność.
Stukanie klawiatury wypadło najbardziej przekonująco. Widać pojedyncze uderzenia w czterech seriach z przerwami między nimi, tak jak przy prawdziwym pisaniu, a nie jednolity szum.
Szum przejścia jest raczej niski niż „lekki i powietrzny”, o jaki prosiłem. Prawie całą energię (97%) ma w paśmie 30–130 Hz. Wyższe dźwięki narastają tylko między 0,3 a 1,2 s, a całość cichnie przed 2 s, choć zamówiłem 2,5 s.
Uderzenie ma mocny początek, ale wybrzmienie nie jest krótkie. Niski dźwięk około 50 Hz opada przez 2,5 s (z −6 do −41 dBFS RMS w kolejnych połówkach sekundy) i wciąż brzmi, gdy plik kończy się na 3 s. Dlatego końcówkę trzeba przyciąć z wyciszeniem.
Tło dźwiękowe lasu jest bardzo ciche. Ma RMS −43 dBFS w stereo, podczas gdy uderzenie ma −14 dBFS, a szum przejścia −17 dBFS. Prawie całą energię ma poniżej 100 Hz, a 88% nawet poniżej 30 Hz, czyli w paśmie, którego głośnik telefonu nie zagra. Zanim je podgłośnię, wycinam to dudnienie filtrem górnoprzepustowym około 80 Hz, tak jak nagrania terenowe w Few Summers. Na spektrogramie jest też cienka, stała linia około 6,6 kHz, która może udawać świerszcze z opisu, choć brakuje jej rytmicznego cykania.
Dwa problemy dotyczą kilku efektów naraz:
- uderzenie i tło lasu mają kanały częściowo w przeciwfazie. Po złożeniu do mono, tak jak w głośniku telefonu, uderzenie traci 6,6 dB, a tło lasu 8,1 dB. Klawiatura ma kanały zgodne i nie traci nic,
- trzy z czterech efektów kończą się ciszą przed czasem: szum przejścia po 1,9 s z 2,5, klawiatura po 5,7 s z 6, a tło lasu po 9,2 s z 10.
Przeciwfaza to częsty problem efektów z modelu, więc każdy efekt sprawdzam też po złożeniu do mono. Z trzech wersji CLAP wybrał dla szumu przejścia trzecią (0,48), dla uderzenia drugą (0,38), dla klawiatury trzecią (0,45), a dla tła lasu pierwszą (0,40). Wszystkie 12 wersji przekroczyło próg 0,20 (najniższy wynik to 0,27), a różnice między wersjami jednego opisu wynosiły 0,04–0,11. Wybrane tło lasu to właśnie to ciche i dudniące, co pokazuje, że CLAP nie ocenia jakości.
Wyniki: czas i CLAP
| 3 wersje | Na 1 s dźwięku | CLAP 3 wersji | Wybrana | |
|---|---|---|---|---|
| Szum przejścia, 2,5 s | 334,8 s | 44,6 s | 0,41 / 0,37 / 0,48 | 3. |
| Uderzenie, 3 s | 354,1 s | 39,3 s | 0,27 / 0,38 / 0,30 | 2. |
| Klawiatura, 6 s | 356,1 s | 19,8 s | 0,39 / 0,40 / 0,45 | 3. |
| Tło lasu, 10 s | 354,3 s | 11,8 s | 0,40 / 0,36 / 0,38 | 1. |
Najważniejsza lekcja z tej tabeli: czas prawie nie zależy od długości efektu. Szum przejścia 2,5 s i tło lasu 10 s kosztują tyle samo, około 2 minut na wersję. Trzy wersje liczą się razem w jednym wywołaniu, więc to średnia, a nie czas pojedynczej wersji.
Przyczynę znalazłem w kodzie biblioteki diffusers. Model zawsze liczy pełne okno, na jakie go zbudowano, czyli około 47 s dźwięku (karta modelu podaje to samo jako maksimum). Dopiero na końcu przycina wynik do żądanej długości. Według dokumentacji diffusers domyślna długość to 47,55 s, a długość dźwięku model dostaje jako osobną informację o czasie.
Krótkie efekty są więc najdroższe w przeliczeniu na sekundę. Jeśli potrzebujesz kilku krótkich dźwięków, taniej powinno być wygenerować jeden dłuższy i pociąć go, choć tego nie mierzyłem.
Pozostałe pomiary:
- wczytanie modelu trwało 5,5 s, a skopiowanie pliku z zewnętrznego dysku 6,7 s,
- model w fp32 zajmuje 4,9 GB, a przed testem wolne było 19,4 GB z 32 GB, więc mieści się z dużym zapasem,
- wersji na samym procesorze nie mierzyłem.
Jeden wyjątek: pierwsza seria wersji szumu przejścia trwała 253 s, a wszystkie kolejne 334–359 s. Nie wiem dokładnie dlaczego. Przypuszczam, że przy dłuższej pracy Mac obniżył taktowanie karty graficznej.
Lokalnie czy przez API
Stability AI udostępnia nowsze modele dźwiękowe przez API, czyli jako płatną usługę w chmurze. Według cennika Stability jeden kredyt kosztuje 0,01 USD, a jeden dźwięk ze Stable Audio 2.5 lub 3.0 to 8 kredytów, czyli 0,08 USD za dźwięk do trzech minut. W cenniku ElevenLabs efekty dźwiękowe kosztują 0,12 USD za minutę.
Moje cztery efekty po trzy wersje kosztowałyby w API Stability 0,96 USD, a w ElevenLabs około 0,13 USD, licząc 0,12 USD za minutę dźwięku. Na Macu 12 wersji (cztery opisy po trzy) to razem około 23 minut pracy karty graficznej, więc w nocy spokojnie zmieści się kilkadziesiąt opisów.
Pieniądze znowu nie są głównym argumentem. Za modelem na własnym komputerze przemawia to, że mogę wygenerować w nocy kilkadziesiąt wersji, odsiać je CLAP-em i nie martwić się limitami.
Licencja też jest przejrzysta. Według Stability AI Community License:
- model jest darmowy, także do użytku komercyjnego, dla osób i firm z rocznym przychodem poniżej 1 mln USD,
- do użytku komercyjnego trzeba się zarejestrować w Stability AI,
- próg liczy się razem z firmami powiązanymi,
- powyżej progu trzeba poprosić Stability o osobną licencję, a firma decyduje, czy jej udzieli.
Pliki modelu na Hugging Face wymagają zalogowania i akceptacji warunków.
Na co uważać
Model najlepiej radzi sobie z krótkimi, jednolitymi dźwiękami. Przy dłuższych nagraniach otoczenia charakter dźwięku potrafi nagle zmienić się w połowie. W projekcie z dłuższych nagrań z biblioteki wycinam najspokojniejszy fragment: szukam miejsca o najbardziej równej głośności, bez nagłych skoków. To samo warto zrobić z dłuższym dźwiękiem z modelu.
Przed miksem ściszam najgłośniejszy punkt każdego efektu do około −3 dBFS, bo plik ze stukaniem klawiatury po kompresji AAC ma szczyt około +0,6 dBFS, czyli powyżej poziomu, przy którym dźwięk się przesterowuje.
Mowy i śpiewu ten model nie tworzy dobrze i nie jest do tego przeznaczony, dlatego negatywny prompt zawiera słowa „speech, talking”. Do sprawdzania, co jest w gotowym dźwięku, używam też modelu AST, który opisuję w jednej z kolejnych części serii. O zamianie mowy na tekst na własnym komputerze piszę w części o Whisperze, a szerzej o tworzeniu dźwięku i głosu z AI w przewodniku o obrazie, wideo i głosie z AI.
Jak zmiksować efekt z mową
Wygenerowany efekt rzadko brzmi dobrze sam. W rolce dźwięk ma trzy warstwy: mowę, podkład i efekty, a mowa zawsze jest najważniejsza. W mojej rolce o modelach viral-hub (wersja 13) cały miks ma średnio −17,1 dB, a najgłośniejszy punkt −1,5 dB. Efekty są wyraźnie cichsze od głosu. Kilka zasad, których się trzymam:
- Efekt przejścia zaczyna się chwilę przed cięciem i kończy chwilę po nim. Szum, który startuje dokładnie na cięciu, brzmi jak spóźniony.
- Uderzenie na początku rolki ustawiam na pierwszym akcencie mowy albo na pojawieniu się pierwszej planszy, nigdy w środku słowa.
- Tło dźwiękowe ściszam pod mową o kilka do kilkunastu decybeli i podgłaśniam w pauzach. Tak działa typowy miks.
- Każdy efekt przycinam z krótkim wyciszeniem na końcu, żeby nie urywał się w połowie.
Te zasady działają niezależnie od tego, skąd pochodzi efekt. Z gotowej biblioteki biorę dźwięk o znanym charakterze, a z modelu dostaję coś nowego, co trzeba najpierw odsłuchać i przyciąć. Dlatego w studiu efekt z modelu przechodzi przez te same kroki co dźwięk z biblioteki: przycięcie ciszy, wyrównanie głośności i dopiero potem ustawienie na osi czasu rolki.
Werdykt
Stable Audio Open zastępuje mi bibliotekę efektów tam, gdzie gotowego dźwięku nie ma. Razem z CLAP-em daje proces, który da się zautomatyzować: opis, kilka wersji, automatyczny wybór i krótki odsłuch. Do typowych szumów i uderzeń wciąż wolę sprawdzone dźwięki na licencji CC0, bo są przewidywalne.
Dźwięk w rolkach i automatyczny wybór wersji mogę pokazać Ci na warsztatach AI 1:1.